


XormのBulk Insertの速度改善
 Yu Takahashi10 min read
XormのBulk Insert(一括登録)で、件数が多い場合に遅くなったので色々試して速くしました。
過去にもXormの記事を書いているので、よろしければどうぞ。
 Yu Takahashi
 Yu Takahashi
環境
- Golang : 1.15.8
- Xorm : 0.8.2
- PostgreSQL : 13.2
以下のテーブルのusers だけ使います。
| create table users( | |
| id BIGSERIAL, | |
| first_name VARCHAR(20) NOT NULL, | |
| last_name VARCHAR(20) NOT NULL, | |
| first_name_kana VARCHAR(20), | |
| last_name_kana VARCHAR(20), | |
| version BIGINT NOT NULL, | |
| created_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, | |
| updated_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, | |
| deleted_at TIMESTAMP, | |
| PRIMARY KEY (id) | |
| ); | |
| create table friends( | |
| id BIGSERIAL, | |
| user_id BIGINT NOT NULL, | |
| friend_id BIGINT NOT NULL, | |
| version BIGINT NOT NULL, | |
| created_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, | |
| updated_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, | |
| deleted_at TIMESTAMP, | |
| PRIMARY KEY (id), | |
| FOREIGN KEY (user_id) REFERENCES users (id), | |
| FOREIGN KEY (friend_id) REFERENCES users (id) | |
| ); |
通常の Insert
普通にinsertするとこんな感じです。
| package main | |
| import ( | |
| "fmt" | |
| "log" | |
| "time" | |
| _ "github.com/lib/pq" | |
| "xorm.io/core" | |
| "xorm.io/xorm" | |
| ) | |
| func main() { | |
| engine, err := xorm.NewEngine("postgres", "postgres://user:password@db/database?sslmode=disable") | |
| if err != nil { | |
| log.Println(err) | |
| return | |
| } | |
| defer engine.Close() | |
| engine.ShowSQL(true) | |
| engine.SetMapper(core.GonicMapper{}) | |
| const count = 10 | |
| us := make([]user, 0, count) | |
| for i := 0; i < count; i++ { | |
| us = append(us, user{ | |
| FirstName: fmt.Sprintf("太郎%v", i), | |
| LastName: fmt.Sprintf("テスト%v", i), | |
| FirstNameKana: fmt.Sprintf("タロウ%v", i), | |
| LastNameKana: fmt.Sprintf("テスト%v", i), | |
| }) | |
| } | |
| err = insert(engine, us) | |
| log.Println(err) | |
| engine.Unscoped().Where("id > ?", 0).Delete(user{}) | |
| } | |
| type user struct { | |
| ID uint64 `xorm:"autoincr"` | |
| FirstName string | |
| LastName string | |
| FirstNameKana string | |
| LastNameKana string | |
| Version uint64 `xorm:"version"` | |
| CreatedAt time.Time `xorm:"created"` | |
| UpdatedAt time.Time `xorm:"updated"` | |
| DeletedAt time.Time `xorm:"deleted"` | |
| } | |
| func (user) TableName() string { | |
| return "users" | |
| } | |
| func insert(db xorm.Interface, us users) error { | |
| _, err := db.Insert(&us) | |
| return err | |
| } |
通常のInsert メソッドについて、件数を変えてベンチマークを取ってみます。あとで使いまわすのでbase 関数で共通化しています。DBに繋ぐテストのため、DBの性能によっても結果は変わると思います。
| package main | |
| import ( | |
| "fmt" | |
| "testing" | |
| "xorm.io/core" | |
| "xorm.io/xorm" | |
| ) | |
| func base(b *testing.B, insertCount int, fn func(xorm.Interface, users) error) { | |
| us := make(users, 0, insertCount) | |
| for i := 0; i < insertCount; i++ { | |
| us = append(us, user{ | |
| FirstName: fmt.Sprintf("太郎+%v", i), | |
| LastName: fmt.Sprintf("テスト+%v", i), | |
| FirstNameKana: fmt.Sprintf("タロウ+%v", i), | |
| LastNameKana: fmt.Sprintf("テスト+%v", i), | |
| }) | |
| } | |
| engine, err := xorm.NewEngine("postgres", "postgres://user:password@db/database?sslmode=disable") | |
| if err != nil { | |
| panic(err) | |
| } | |
| defer engine.Close() | |
| engine.SetMapper(core.GonicMapper{}) | |
| b.ResetTimer() | |
| for i := 0; i < b.N; i++ { | |
| b.StartTimer() | |
| _, err := engine.Transaction(func(tx *xorm.Session) (interface{}, error) { | |
| err := fn(tx, us) | |
| return nil, err | |
| }) | |
| if err != nil { | |
| panic(err) | |
| } | |
| b.StopTimer() | |
| engine.Unscoped().Where("id > ?", 0).Delete(user{}) | |
| } | |
| } | |
| func Benchmark_insert_1(b *testing.B) { | |
| base(b, 1, insert) | |
| } | |
| func Benchmark_insert_10(b *testing.B) { | |
| base(b, 10, insert) | |
| } | |
| func Benchmark_insert_100(b *testing.B) { | |
| base(b, 100, insert) | |
| } | |
| func Benchmark_insert_1000(b *testing.B) { | |
| base(b, 1000, insert) | |
| } |
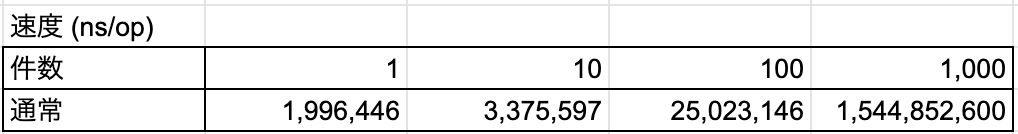
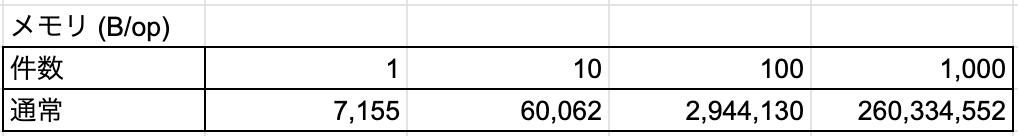
1,000件のinsertで約1.5秒かかっています。100件が0.025秒であることを考えると、だいぶ遅いように見えます。
100件ごとに分割する
100件が0.025秒なら、1,000件を100件 × 10回のinsertに分割することで速くなるのでは?と思い試してみました。
| func splitInsert(db xorm.Interface, us users) error { | |
| const limit = 100 | |
| for start := 0; start < us.Len(); start += limit { | |
| end := start + limit | |
| if end > us.Len() { | |
| end = us.Len() | |
| } | |
| target := us[start:end] | |
| _, err := db.Insert(&target) | |
| if err != nil { | |
| return err | |
| } | |
| } | |
| return nil | |
| } |
| func Benchmark_splitInsert_1(b *testing.B) { | |
| base(b, 1, splitInsert) | |
| } | |
| func Benchmark_splitInsert_10(b *testing.B) { | |
| base(b, 10, splitInsert) | |
| } | |
| func Benchmark_splitInsert_100(b *testing.B) { | |
| base(b, 100, splitInsert) | |
| } | |
| func Benchmark_splitInsert_1000(b *testing.B) { | |
| base(b, 1000, splitInsert) | |
| } | |
| func Benchmark_splitInsert_10000(b *testing.B) { | |
| base(b, 10000, splitInsert) | |
| } |
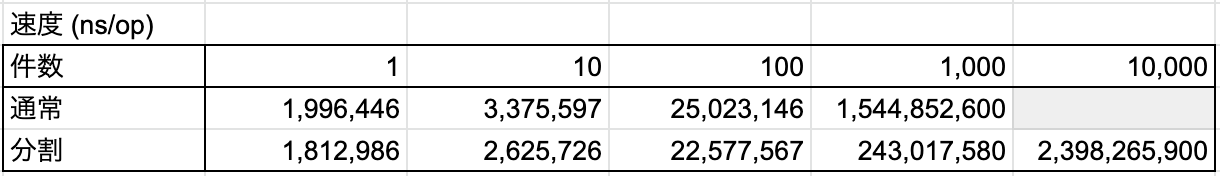
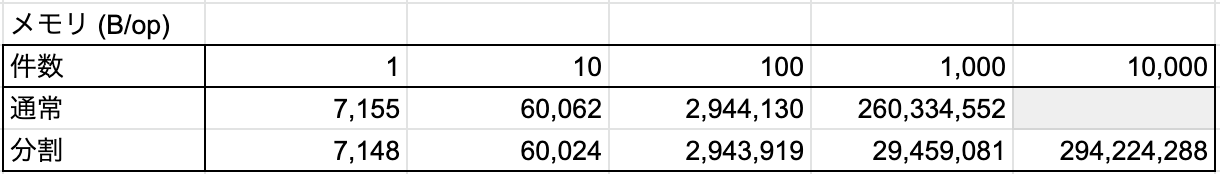
期待通り、1,000件の速度 ≒ 100件の速度 × 10 になりました。この修正は手軽にできて効果もありますが、10,000件になると約2.4秒となり、少し気になってきます。できればもう少し速くしたいです。
自分でSQLを構築する
Xorm の力を極力借りず、自分で構築していきます。
| type bulkInserter interface { | |
| TableName() string | |
| Args(int) []interface{} | |
| Columns() string | |
| Values() string | |
| Len() int | |
| } | |
| const pqArgLimit = 65535 | |
| type config struct { | |
| returningColumns []string | |
| } | |
| type Option func(*config) | |
| func Returning(columns ...string) Option { | |
| return func(c *config) { | |
| c.returningColumns = columns | |
| } | |
| } | |
| func BulkInsert(db xorm.Interface, inserter bulkInserter, options ...Option) ([]map[string]string, error) { | |
| insertCount := inserter.Len() | |
| if insertCount == 0 { | |
| return nil, nil | |
| } | |
| c := &config{} | |
| for _, opt := range options { | |
| opt(c) | |
| } | |
| var results []map[string]string | |
| returning := "" | |
| // RETURNING を使用する場合はSQLと返却値を用意する | |
| if len(c.returningColumns) > 0 { | |
| returning = fmt.Sprintf(" RETURNING %s", strings.Join(c.returningColumns, ", ")) | |
| results = make([]map[string]string, 0, insertCount) | |
| } | |
| valuesString := inserter.Values() + "," | |
| argCount := len(inserter.Args(0)) | |
| // "github.com/lib/pq" の引数の上限を超えないよう分割する | |
| insertLimit := pqArgLimit/argCount - 1 | |
| for start := 0; start < insertCount; start += insertLimit { | |
| end := start + insertLimit | |
| if end > insertCount { | |
| end = insertCount | |
| } | |
| var values strings.Builder | |
| values.Grow(len([]byte(valuesString)) * (end - start)) | |
| args := make([]interface{}, 0, (end-start)*argCount) | |
| for i := start; i < end; i++ { | |
| args = append(args, inserter.Args(i)...) | |
| values.WriteString(valuesString) | |
| } | |
| sql := fmt.Sprintf( | |
| "INSERT INTO %s (%s) VALUES %s%s", | |
| inserter.TableName(), | |
| inserter.Columns(), | |
| strings.TrimRight(values.String(), ","), | |
| returning, | |
| ) | |
| result, err := db.QueryString(append([]interface{}{sql}, args...)...) | |
| if err != nil { | |
| return nil, err | |
| } | |
| if len(c.returningColumns) > 0 { | |
| results = append(results, result...) | |
| } | |
| } | |
| return results, nil | |
| } |
以下のように使います。
| func main() { | |
| engine, err := xorm.NewEngine("postgres", "postgres://user:password@db/database?sslmode=disable") | |
| if err != nil { | |
| log.Println(err) | |
| return | |
| } | |
| defer engine.Close() | |
| engine.ShowSQL(true) | |
| engine.SetMapper(core.GonicMapper{}) | |
| const count = 20000 | |
| us := make(users, 0, count) | |
| for i := 0; i < count; i++ { | |
| us = append(us, user{ | |
| FirstName: fmt.Sprintf("太郎%v", i), | |
| LastName: fmt.Sprintf("テスト%v", i), | |
| FirstNameKana: fmt.Sprintf("タロウ%v", i), | |
| LastNameKana: fmt.Sprintf("テスト%v", i), | |
| }) | |
| } | |
| result, err := BulkInsert(engine, us, Returning("id")) | |
| if err != nil { | |
| log.Println(err) | |
| return | |
| } | |
| log.Println(result) | |
| engine.Unscoped().Where("id > ?", 0).Delete(user{}) | |
| } | |
| type users []user | |
| func (users) TableName() string { | |
| return "users" | |
| } | |
| func (us users) Len() int { | |
| return len(us) | |
| } | |
| func (us users) Columns() string { | |
| return "first_name,last_name,first_name_kana,last_name_kana,version" | |
| } | |
| func (us users) Values() string { | |
| return "(?,?,?,?,?)" | |
| } | |
| func (us users) Args(i int) []interface{} { | |
| return []interface{}{us[i].FirstName, us[i].LastName, us[i].FirstNameKana, us[i].LastNameKana, 1} | |
| } |
user 構造体のスライスusers に以下のinterfaceを実装しています。このinterfaceを実装するとBulkInsert 関数に渡すことができます。
type bulkInserter interface {
    TableName() string
    Args(int) []interface{}
    Columns() string
    Values() string
    Len() int
}
Xorm は内部で lib/pq を使用しており、このライブラリでSQLにバインドできる引数の上限が 65535 となっているため、それを超えないように分割して処理しています。
オプションとしてRETURNING 句をセットできるようにしているので、後続の処理でinsert結果のIDを使用したい時も使えます。オプションの実装にFunctional Option Pattern を使用しているので、将来的な拡張もしやすいと思います。例えばON CONFLICT 句を使いたくなったら以下のように拡張できます。
| type config struct { | |
| returningColumns []string | |
| onConflict string | |
| } | |
| type Option func(*config) | |
| func Returning(columns ...string) Option { | |
| return func(c *config) { | |
| c.returningColumns = columns | |
| } | |
| } | |
| func OnConflict(onConflict string) Option { | |
| return func(c *config) { | |
| c.onConflict = onConflict | |
| } | |
| } | |
| func (c config) optionalSQL() string { | |
| returning := "" | |
| if len(c.returningColumns) > 0 { | |
| returning = fmt.Sprintf(" RETURNING %s", strings.Join(c.returningColumns, ",")) | |
| } | |
| onConflict := "" | |
| if c.onConflict != "" { | |
| onConflict = fmt.Sprintf(" ON CONFLICT %s", c.onConflict) | |
| } | |
| return onConflict + returning | |
| } | |
| func (c config) hasReturn() bool { | |
| return len(c.returningColumns) > 0 | |
| } | |
| func BulkInsert(db xorm.Interface, inserter bulkInserter, options ...Option) ([]map[string]string, error) { | |
| insertCount := inserter.Len() | |
| if insertCount == 0 { | |
| return nil, nil | |
| } | |
| c := &config{} | |
| for _, opt := range options { | |
| opt(c) | |
| } | |
| var results []map[string]string | |
| if c.hasReturn() { | |
| results = make([]map[string]string, 0, insertCount) | |
| } | |
| optionalSQL := c.optionalSQL() | |
| valuesString := inserter.Values() + "," | |
| argCount := len(inserter.Args(0)) | |
| insertLimit := pqArgLimit/argCount - 1 | |
| for start := 0; start < insertCount; start += insertLimit { | |
| end := start + insertLimit | |
| if end > insertCount { | |
| end = insertCount | |
| } | |
| var values strings.Builder | |
| values.Grow(len([]byte(valuesString)) * (end - start)) | |
| args := make([]interface{}, 0, (end-start)*argCount) | |
| for i := start; i < end; i++ { | |
| args = append(args, inserter.Args(i)...) | |
| values.WriteString(valuesString) | |
| } | |
| sql := fmt.Sprintf( | |
| "INSERT INTO %s (%s) VALUES %s%s", | |
| inserter.TableName(), | |
| inserter.Columns(), | |
| strings.TrimRight(values.String(), ","), | |
| optionalSQL, | |
| ) | |
| result, err := db.QueryString(append([]interface{}{sql}, args...)...) | |
| if err != nil { | |
| return nil, err | |
| } | |
| if c.hasReturn() { | |
| results = append(results, result...) | |
| } | |
| } | |
| return results, nil | |
| } |
こちらもベンチマークを取ります。
| func bulkInsert(db xorm.Interface, us users) error { | |
| _, err := BulkInsert(db, us) | |
| return err | |
| } | |
| func Benchmark_bulkInsert_1(b *testing.B) { | |
| base(b, 1, bulkInsert) | |
| } | |
| func Benchmark_bulkInsert_10(b *testing.B) { | |
| base(b, 10, bulkInsert) | |
| } | |
| func Benchmark_bulkInsert_100(b *testing.B) { | |
| base(b, 100, bulkInsert) | |
| } | |
| func Benchmark_bulkInsert_1000(b *testing.B) { | |
| base(b, 1000, bulkInsert) | |
| } | |
| func Benchmark_bulkInsert_10000(b *testing.B) { | |
| base(b, 10000, bulkInsert) | |
| } | |
| func Benchmark_bulkInsert_100000(b *testing.B) { | |
| base(b, 100000, bulkInsert) | |
| } |
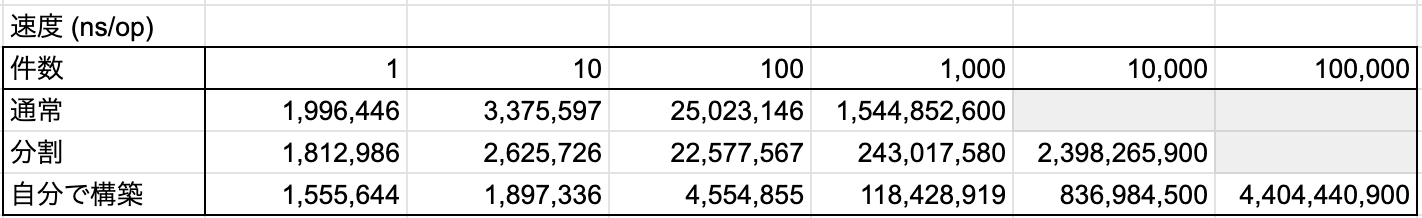
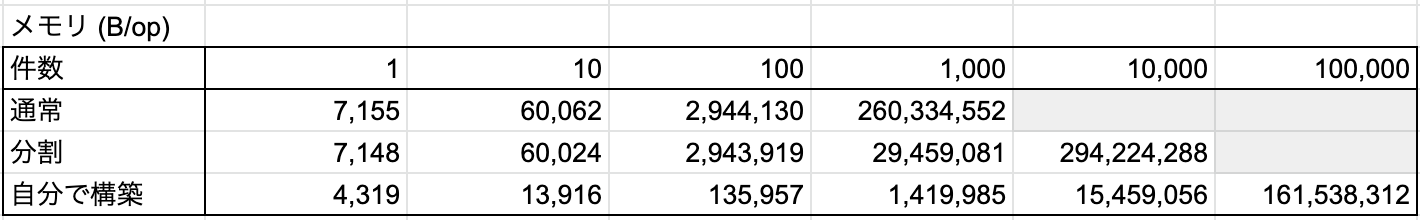
さらに速くなりました。分割した場合と比較すると10,000件は約2.9倍の速度で、100,000件でも約4.4秒で完了します。メモリ消費についても、100件以降で見ると約20倍少なくなっています。
まとめ
自分でSQLを構築することで
- 速度の向上
- メモリ消費削減
- Bulkでも自動採番のID取得可能
と、中々いい感じになりました。
最後に測定結果を貼っておきます。登録件数が多い場合、施行回数が少なくなっているので、多少の誤差はあると思います。
| Benchmark_insert_1-4 637 1996446 ns/op 7155 B/op 171 allocs/op | |
| Benchmark_insert_10-4 403 3375597 ns/op 60062 B/op 1862 allocs/op | |
| Benchmark_insert_100-4 46 25023146 ns/op 2944130 B/op 117100 allocs/op | |
| Benchmark_insert_1000-4 1 1544852600 ns/op 260334552 B/op 11072318 allocs/op | |
| Benchmark_splitInsert_1-4 594 1812986 ns/op 7148 B/op 171 allocs/op | |
| Benchmark_splitInsert_10-4 441 2625726 ns/op 60024 B/op 1861 allocs/op | |
| Benchmark_splitInsert_100-4 49 22577567 ns/op 2943919 B/op 117099 allocs/op | |
| Benchmark_splitInsert_1000-4 5 243017580 ns/op 29459081 B/op 1170782 allocs/op | |
| Benchmark_splitInsert_10000-4 1 2398265900 ns/op 294224288 B/op 11707072 allocs/op | |
| Benchmark_bulkInsert_1-4 675 1555644 ns/op 4319 B/op 81 allocs/op | |
| Benchmark_bulkInsert_10-4 626 1897336 ns/op 13916 B/op 264 allocs/op | |
| Benchmark_bulkInsert_100-4 237 4554855 ns/op 135957 B/op 2322 allocs/op | |
| Benchmark_bulkInsert_1000-4 21 118428919 ns/op 1419985 B/op 24852 allocs/op | |
| Benchmark_bulkInsert_10000-4 2 836984500 ns/op 15459056 B/op 249985 allocs/op | |
| Benchmark_bulkInsert_100000-4 1 4404440900 ns/op 161538312 B/op 2499028 allocs/op |