


既存の AWS 環境を変更ゼロで Terraform に取り込んだ話と、IaC 化の観点
 Kohei Kondo34 min read
はじめに
こんにちは、koheです。
自社 SaaS の AWS 環境(dev 299 件、本番 208 件)を、データも ID も URL も変えずに Terraform に取り込みました。その手順と、どの環境でも使える「既存の環境を IaC に取り込むとき、何を見て、何を決めるか」をまとめます。一部を管理していた元の IaC ツールからの切り離しは、道具に固有の話なので省きます。
先に別の自社サービスで試したときにできていなかったことは、本文の中に「ポイント」として書きました。
全体の流れ
取り込みは、8 つの段階に分けて進めました。段階ごとに、確かめることと、AWS の実物への影響を並べています。
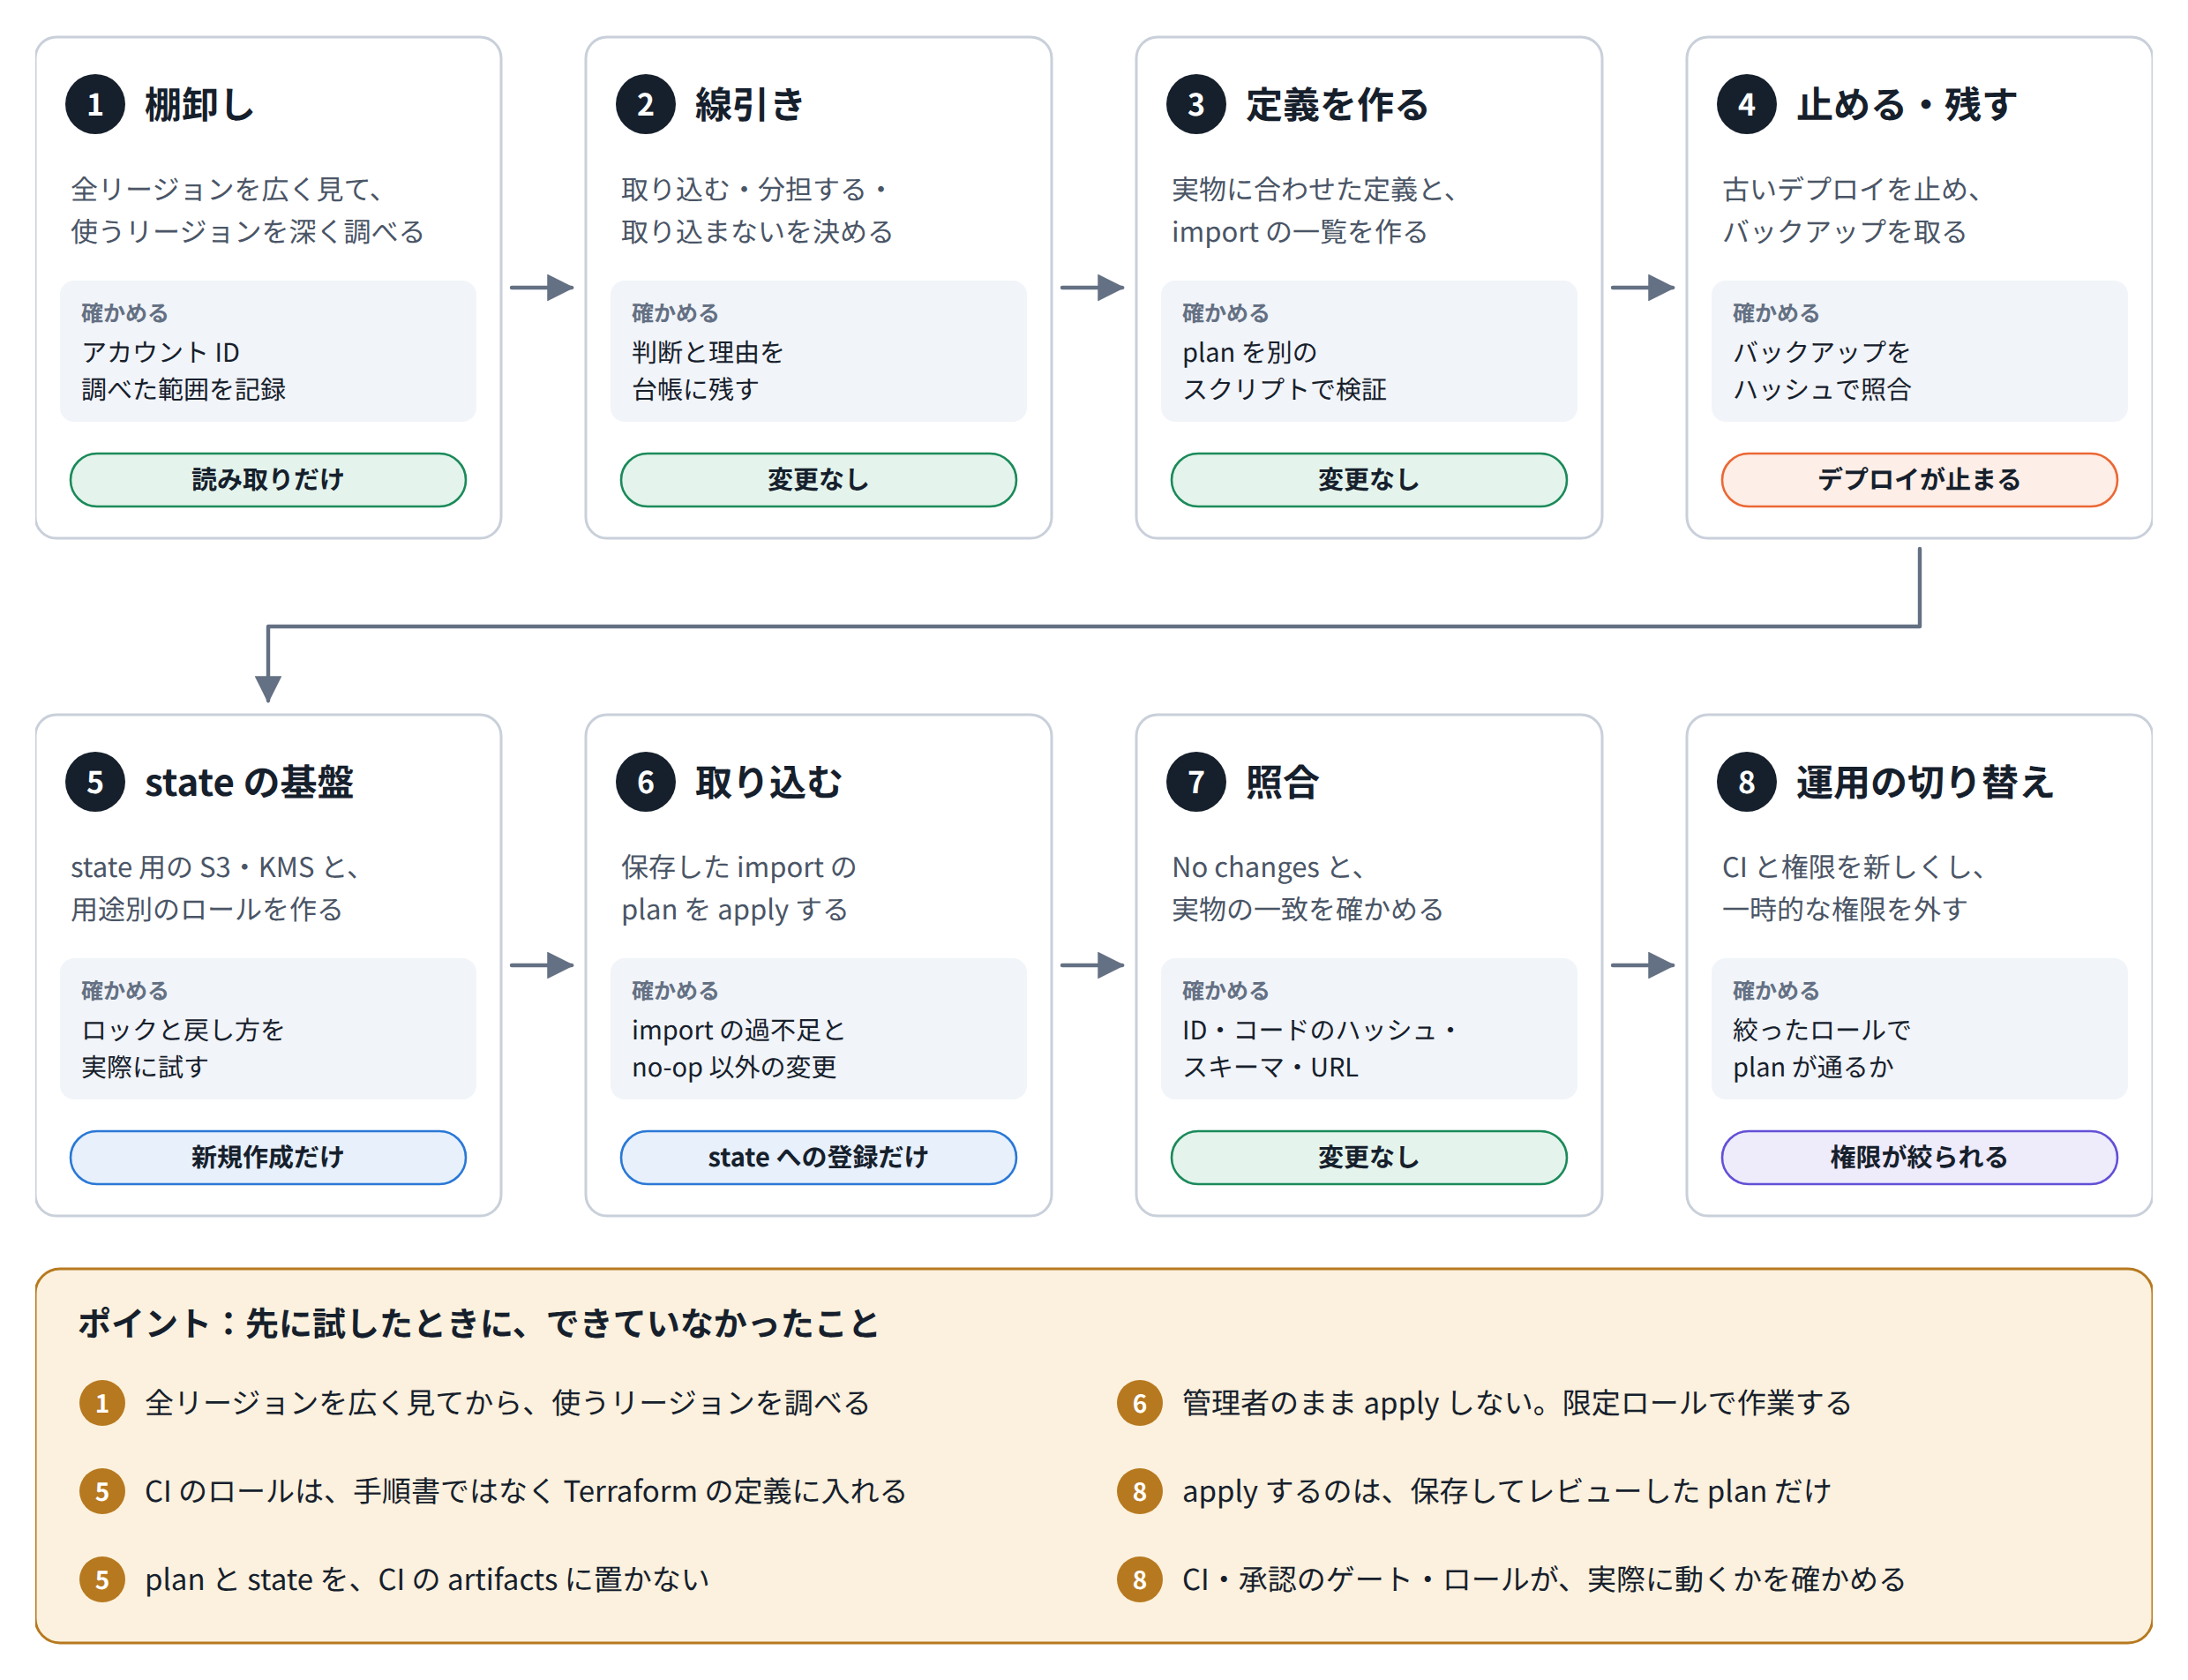
Terraform の import は、AWS の実物を変えません。state に登録するだけです。なので、手順の中でいちばん怖いのは import そのものではなく、取り込みの最中に別の何かが設定を変えることと、実物とずれた定義のまま取り込むことでした。以下の多くは、この 2 つを防ぐための話です。
棚卸し:管理元は 1 つではなかった
最初に、実環境と、それを管理しているはずのものを突き合わせました。わかったのは、管理元が 1 つではないことです。
見つかったもの | 中身 |
|---|---|
管理元が混在 | IaC のプロジェクトが 4 つ。ほかに CloudFormation、SAM、手作業で作ったものが混ざっていた |
参照するだけのテーブル | 定義から参照されているが、作成も管理もされていない DynamoDB テーブルが 2 つ |
定義にない GSI | 実在するテーブルに、定義にない GSI が付いていた |
リポジトリにないスタック | AWS 上にはあるのに、どのリポジトリにも定義がないスタック |
アプリが書き換える設定 | 顧客が登録するたびに、アプリが SQS のポリシーを書き換えていた |
全部のリソースの調べ方
3 段階で調べました。
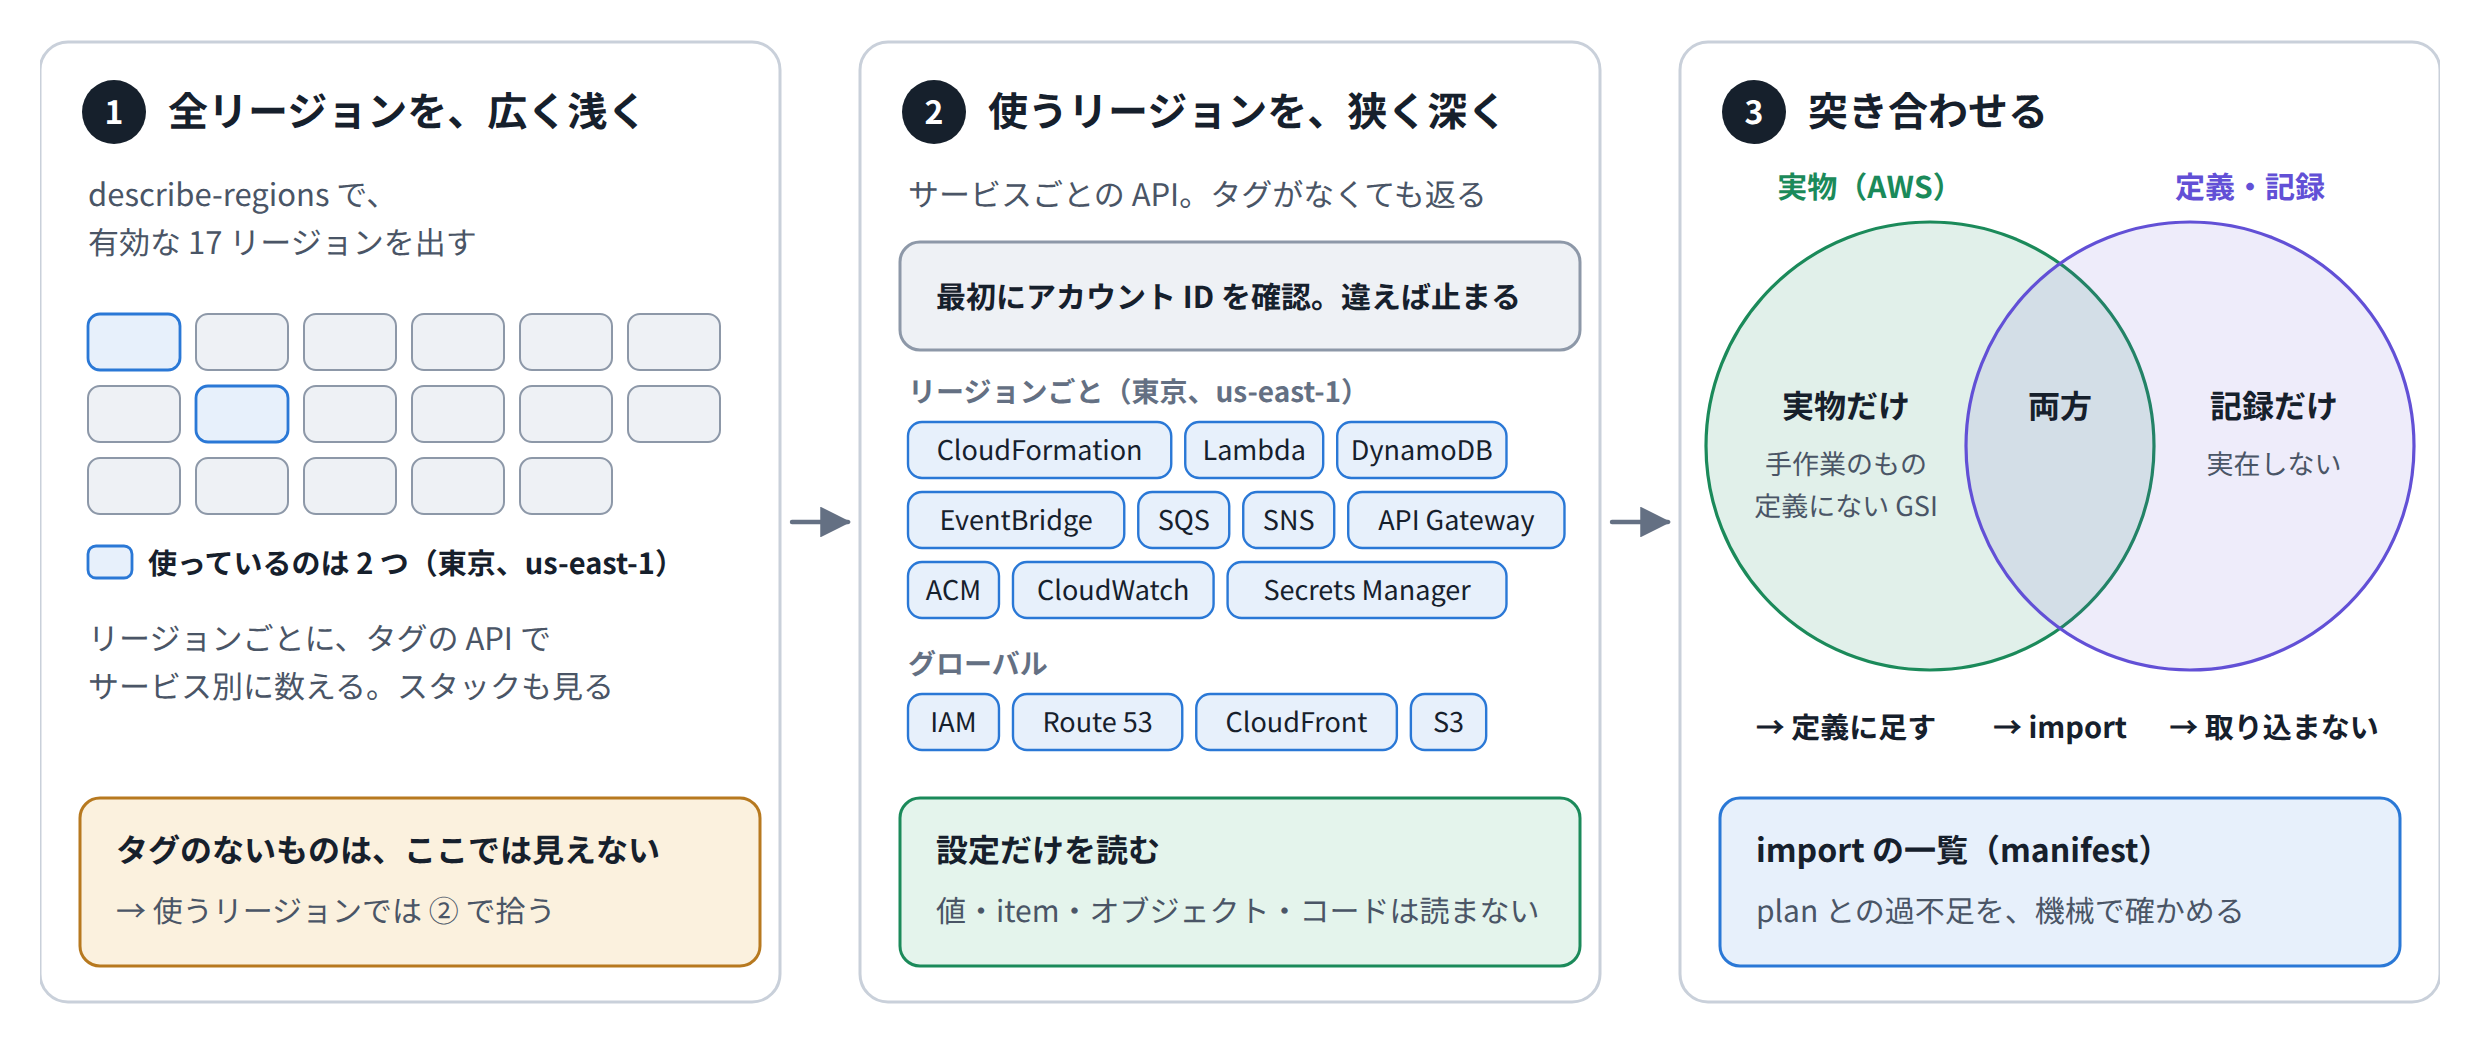
- 全リージョンを、広く浅く見る。
aws ec2 describe-regionsで有効なリージョン(17)を出し、リージョンごとにaws resourcegroupstaggingapi get-resourcesで、タグの付いたリソースをサービス別に数えました。CloudFormation のスタックも見ています。これで、使っているのは東京と us-east-1(CloudFront 用の証明書と WAF)の 2 つだとわかりました。この段階は、使っているリージョンを絞るためのものです。タグのないリソースは、ここでは見えません。 - 使っているリージョンを、狭く深く見る。調査スクリプト(Python と boto3)で、サービスごとに list / describe を呼びました。サービスごとの API は、タグに関係なく全部を返します。タグのないリソースは、ここで拾います。
- 最初に、認証情報のアカウント ID が狙ったものかを確かめる。違えば止まる
- CloudFormation のスタック、スタックが持つリソース、テンプレート。どの IaC が何を管理しているかが、ここでわかる
- Lambda(設定、リソースポリシー、イベントソース)、DynamoDB(TTL、ポイントインタイムリカバリ)、EventBridge(ルール、ターゲット、API destination)、SQS、SNS、API Gateway、ACM、CloudWatch、Secrets Manager(一覧だけ)など
- グローバルな IAM、Route 53、CloudFront、S3
- 突き合わせる。「スタックが管理しているもの」と「実際にあるもの」の差を見ます。上の表の手作業で作ったものや、定義にない GSI は、ここで見つかりました。結果は import の一覧(manifest)にして、あとで plan と過不足がないかを機械で確かめます。
ポイント:使っているリージョンだけを調べると、ほかのリージョンに残っているものに気づけません。先に全リージョンを広く見て、そのあとで使っているリージョンを詳しく調べます。
調べ方で気をつけたのは 3 つです。
- 秘密の値を含めない。調査スクリプトは設定を取る API だけを使い、Secret の値、DynamoDB の item、S3 のオブジェクト、Lambda のコードは読みません。それでも生データには通知先などが含まれるので、Git には入れず、暗号化した S3 と Git 管理外のフォルダに置きました。
- 調べていない範囲を書く。タグのないリソースは 2 段目で拾っていますが、2 段目が届かないところが 2 つあります。ここは「ないことまでは保証していない」と記録に残しました。
- 使っていないリージョンにある、タグのないリソース。1 段目のタグの API は、一度もタグを付けたことのないリソースを返しません
- 2 段目が呼んでいないサービスの、タグのないリソース。2 段目で呼ぶサービスは、1 段目でリソースが見つかったサービスに合わせました。1 段目に EC2 や RDS は出てこなかったので、2 段目では呼んでいません
- 「記録にはあるが、実在しない」ものを分ける。IaC の記録だけを見て import の一覧を作ると、AWS 側にないものまで取り込もうとします。
※ 定義と実物がずれているのは、珍しいことではないと思います。今回は「定義ではなく実物に合わせる」と決めました。定義にない GSI も、実在するので定義に入れています。
タグに頼らずに、全部を見つけるには
今回の 1 段目はタグの API だったので、上の 2 つの穴が残りました。あとから、検証用の環境で、タグにも AWS Config にも頼らない調べ方を試しています。どの環境でも使えるように、準備の要らない道具だけで組みました。
試した結果、今やるなら、3 段階のうち 1 段目と 2 段目を替えます。1 段目はタグの API から Cloud Control と費用の確認へ、2 段目はサービスごとの調査スクリプトから Terraform の plan へ替えて、それぞれの穴をふさぎます。3 段目はそのままです。
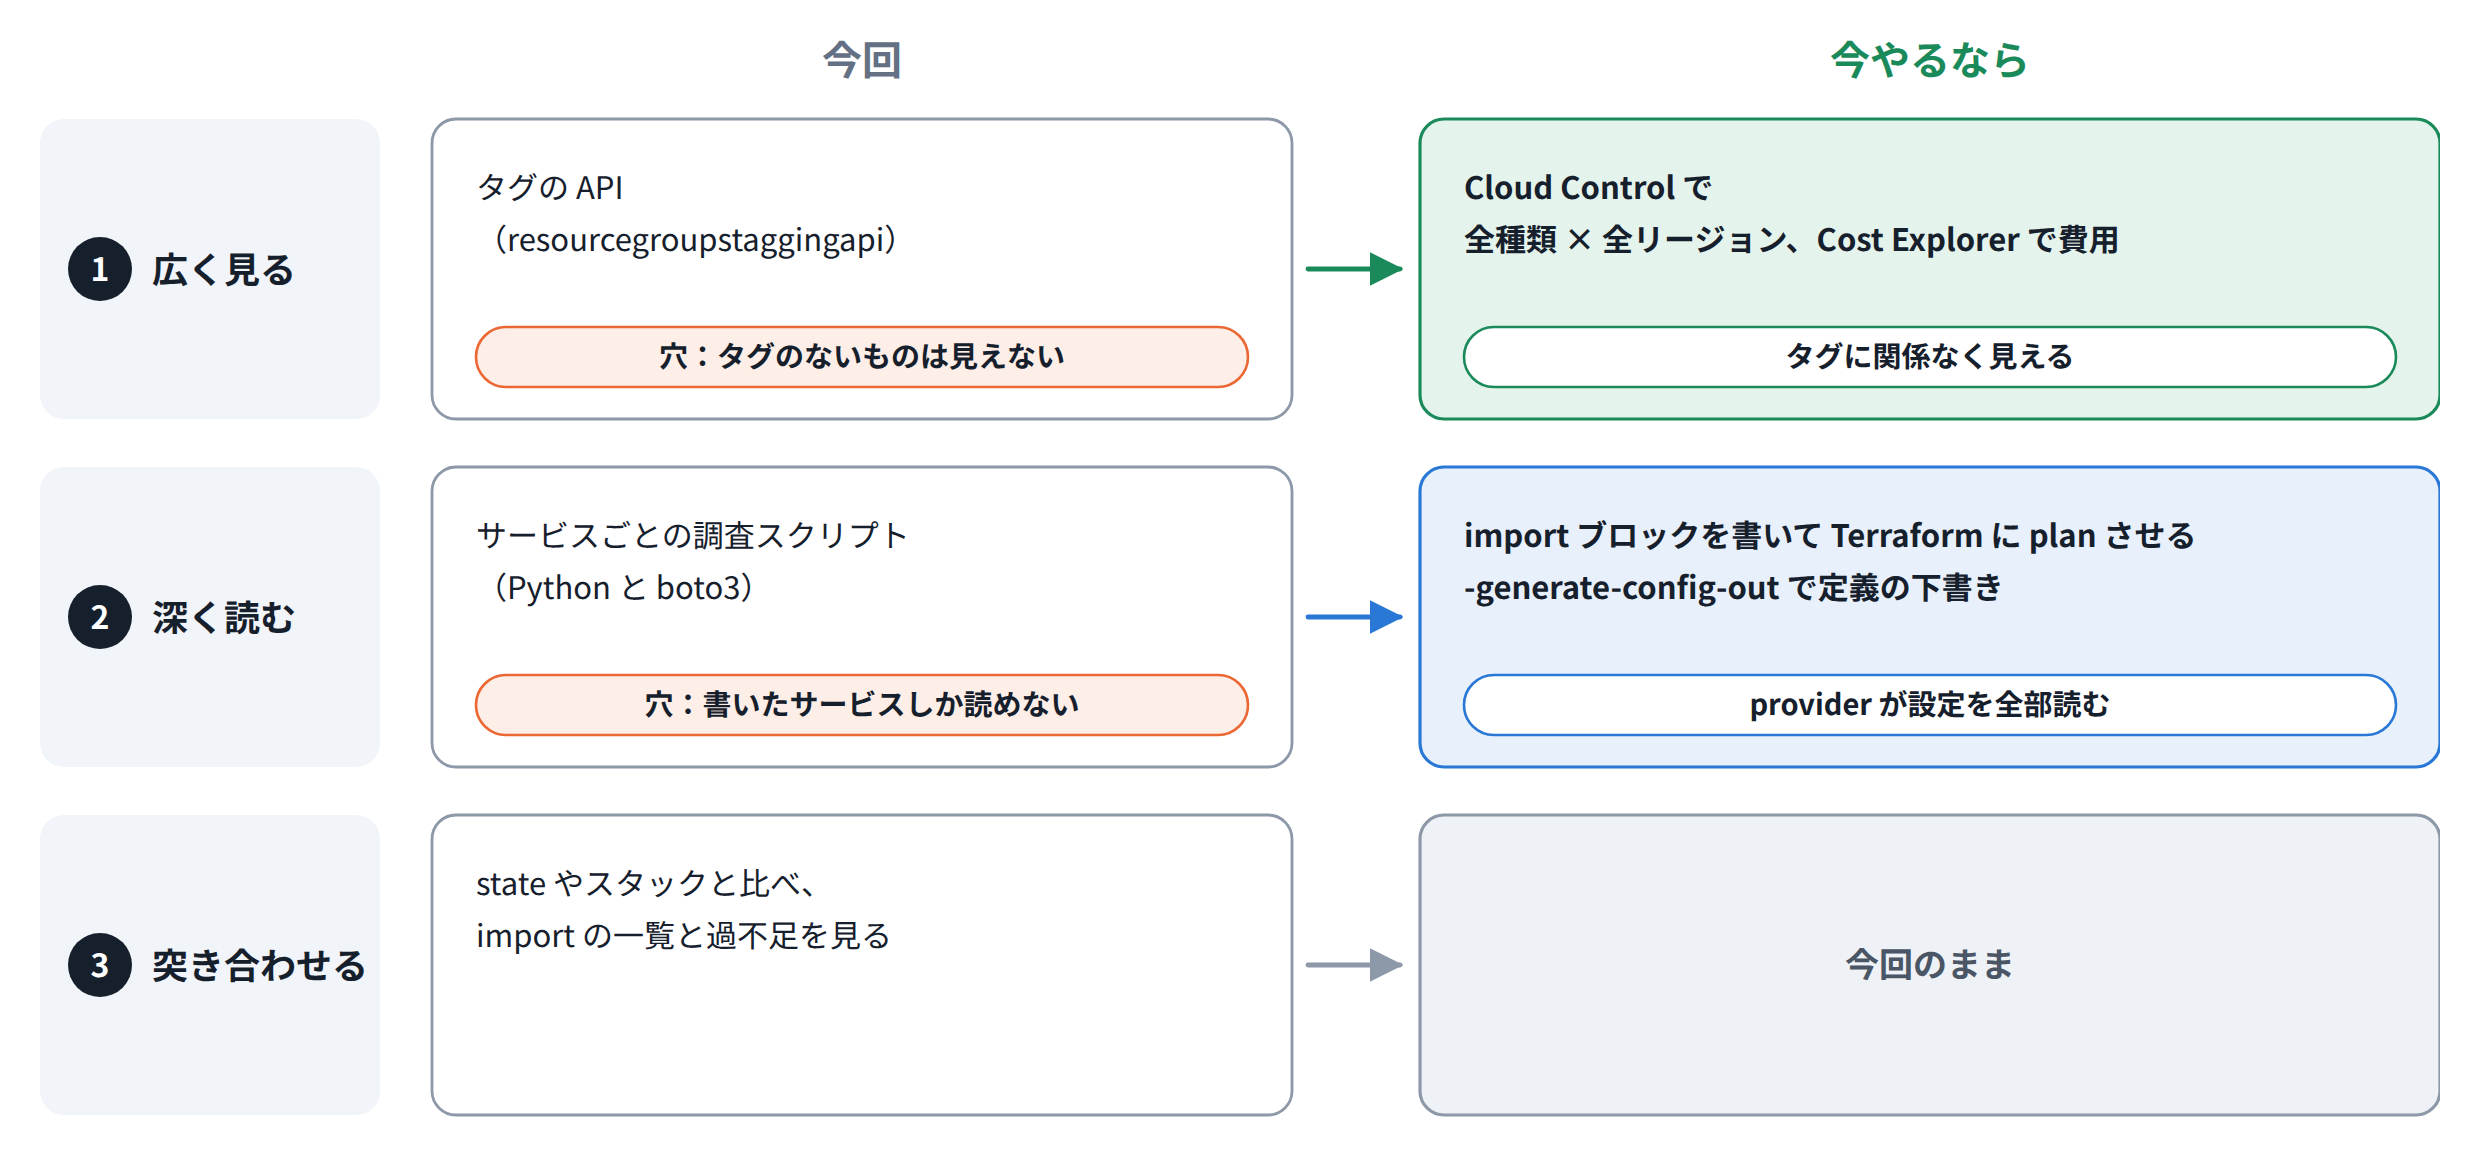
以下、1 段目、2 段目の順に書きます。まず、1 段目に使える道具と、タグのないリソースが見えるかです。
道具 | タグのないもの | 準備 | 注意 |
|---|---|---|---|
タグの API( | 見えない | 要らない | 一度もタグを付けたことのないものは返らない |
AWS Resource Explorer | 既定では一部だけ | 全部を出すなら自分の索引を作る | 既定の索引で出るタグのないものは、一部だけ。自分の索引には、サービスにリンクされたロールの作成が要る |
AWS Config | 見える | 記録を始める | 記録の対象にした種類だけ。記録に費用がかかる |
Cloud Control API( | 見える | 要らない | 種類 × リージョンごとに呼ぶ。親の ID が要る種類や、一覧に対応していない種類がある |
Cost Explorer | 費用が出ていれば見える | 要らない | 無料のリソースは出ない。API は 1 回 0.01 USD |
| 見える | 要らない | 種類を指定して探す。AWS provider 6.63.0 で対応しているのは、1,715 種類のうち 220 種類 |
軸にしたのは、Cloud Control API と Cost Explorer です。Cloud Control API は、どの種類でも同じ形で一覧を取れます。
# 一覧に使える種類(Cloud Control API に対応している種類)
aws cloudformation list-types --type RESOURCE --visibility PUBLIC \
  --provisioning-type FULLY_MUTABLE --region ap-northeast-1

# 種類を指定して一覧にする(タグに関係なく返る)
aws cloudcontrol list-resources --type-name AWS::EC2::Snapshot --region ap-northeast-3
全リージョンを全種類で見るのは重い
Cloud Control API で一覧にできる AWS の種類は、1 リージョンあたり約 1,700 ありました。1 リージョンを全種類で見ると 6 分 40 秒かかり、4,456 件が出ました。
ただ、そのうち約 3,250 件は、AWS が最初から用意しているものです(AWS 管理の IAM ポリシー 1,622、AWS の SSM ドキュメント 829 など)。自分のものと分けないと、一覧として使えません。また、約 1,700 種類のうち 416 種類は親の ID を渡さないと一覧にできず、66 種類は一覧の操作に対応していませんでした。
17 リージョンを全部この方法で見ると、2 時間近くかかります。
「グローバル + 1 リージョン」では足りない
では、メインのリージョンと、グローバルなサービスの us-east-1 だけを見ればよいかというと、そうでもありませんでした。全リージョンを軽く見たところ、メインのリージョンの外で次のものが見つかっています。
リージョン | 見つかったもの | タグの API で見えたか |
|---|---|---|
us-east-1 | Lambda@Edge の関数。CloudFront まわりのものは us-east-1 に置かれる | 見えた |
12 のリージョン | Lambda@Edge が、実行されたリージョンに自動で作るロググループ。リージョンごとのログ保管のリソース | 見えた |
別のリージョン | メールの受信規則と、転送先の SNS トピック。IaC の外にあり、今も使われていた(2 か月で 31 件) | 見えなかった |
大阪 | AMI を別のリージョンにコピーしたときのスナップショット(8 GiB)。AMI は消えていて、スナップショットだけが 3 年あまり残っていた | 見えなかった |
最後の 2 つは、タグがなく、メインのリージョンでもありません。タグの API でも、使うリージョンだけを詳しく見る方法でも、見落とします。どちらも、見つけたあとに片付けました。メールの仕組みは使われていたので Terraform に取り込み、スナップショットは不要だったので消しています。
広く安く見てから、選んだリージョンだけ全部を見る
そこで、次の順番にしました。
- 全リージョンを、少ない種類と費用で見る。Cloud Control API で、費用が出やすい・忘れられやすい 37 種類(EC2、EBS のボリュームとスナップショット、RDS、Lambda、SNS、SES など)だけを一覧にします。17 リージョンで 1 分あまりでした。あわせて Cost Explorer で、前月の費用をリージョン × サービスで見ます。
- 全種類で見るリージョンを決める。1 で自分のリソースが出たリージョンと、us-east-1 を選びます。費用は出ているのに、1 で何も見つからないリージョンも選びます。正体がわかっているもの(上の Lambda@Edge のログなど)しか出ないリージョンは、除外の一覧に入れて外します。
- 選んだリージョンだけ、全種類を一覧にする。親の ID が要る種類は、先に親を一覧にしてから、2 周目で取ります。
- AWS が用意したものを分ける。ARN の持ち主が
awsのもの、AWS-で始まる文書、デフォルト VPC まわりなどを、自分のものと分けます。IAM などのグローバルな種類は、どのリージョンでも同じものが返るので、重複を消します。 - IaC の記録と突き合わせる。
試した環境では、全種類で見るリージョンは 17 から 4 に減り、全体で 40 分ほどでした。ふるいが 1 分あまり、全種類の一覧が 1 リージョンあたり 7〜12 分です。
結果の大半は、AWS やサービスが用意したものでした。
分類 | 件数 |
|---|---|
AWS やサービスが用意・自動作成したもの | 5,368 |
デフォルト VPC まわり | 217 |
正体がわかっていて除外したもの | 49 |
別の種類として重複して返ったもの | 14 |
自分のもの | 723 |
自分のもの 723 件を、Terraform の state と CloudFormation のスタックと突き合わせました。Terraform が管理していたのが 206 件、スタックが 43 件で、ID が一致しない子のリソースが 189 件ありました。残りの 285 件が IaC の外です。手作業やコンソールで作られたもの、手で取った古いバックアップなどで、ひとつずつ正体を確かめてから、取り込むか消すかを決めます。
実際に回してみて、分ける必要があったものは次のとおりです。
- データまで返る種類がある。Cognito のユーザーが数千件返りました。インフラではなくアプリのデータなので、この種類は呼ばないようにしました
- 同じ実体が、別の種類でも返る。Aurora のクラスターやパラメータグループが、Neptune や DocumentDB の種類でも返りました
- サービスが自動で作るものが多い。サービスにリンクされたロール、IAM Identity Center のロール、DB の自動スナップショット、Security Hub が作る Config ルール(356 件)などです。名前の決まった形や、API の「AWS 管理」の印で見分けます
- Terraform と ID が一致しない子のリソースがある。セキュリティグループのルールやサブネットの関連付けは、Terraform では親の属性として書くことが多く、ID では突き合わせられません。IaC の外とは決めつけず、「要確認」に分けました
※ Cost Explorer は、クレジットがあるアカウントでそのまま見ると、どのリージョンも 0 ドルになりました。記録の種類を「使用量」(RECORD_TYPE = Usage)に絞ると、実際の使用分が出ます。
※ どれも読み取りだけで動きます。Cloud Control API は、cloudformation:ListResources に加えて、裏で呼ぶ各サービスの一覧の権限が要ります。ListResources の結果には設定の中身も入るので、保存するのは識別子だけにしました。
※ Cloud Control API は、AWS の種類なら追加料金がかかりません。ただし CloudTrail の証跡が 2 つ以上あるアカウントでは、2 つ目以降の証跡に記録される数万件の読み取りのイベントに、10 万件あたり 2 USD かかります。
2 段目は、Terraform に読ませる
見つけたもののうち、取り込むものは、設定の中身まで読む必要があります。今回はサービスごとの調査スクリプトで読みましたが、これだと書いたサービスしか読めず、種類が増えるたびにスクリプトも増えます。
今やるなら、この「深く読む」は Terraform 自身に任せます。import ブロックを書いて plan すれば、provider が実物の設定を全部読みます。-generate-config-out を付ければ、定義の下書きまで書き出します。plan するだけなら、state も AWS も変わりません。
# imports.tf に import ブロックを書いてから
terraform plan -generate-config-out=generated.tf
検証用の環境で見つけたメールの受信規則は、この形で取り込みました。気をつけるところは 3 つです。
- 下書きは、そのまま使えないことがある。SNS のトピックの下書きに、AWS が受け付けない値(
maximum_message_size = 0、signature_version = 0)が入っていて、plan が通りませんでした。AWS の既定のままでよい属性は消して、要るものだけを残します - 作るときだけ使う設定が、差分に出る。SNS のメールの購読では、
confirmation_timeout_in_minutesなどが「変更」として出ました。AWS には送られない Terraform 側の設定なので、ignore_changesで外しました -generate-config-outは実験的な機能。Terraform 1.5 から入ったもので、生成される形は版によって変わることがあります
terraform query(1.14 から)が対応している種類なら、一覧と下書きを terraform query -generate-config-out でまとめて作れます。ただ、種類を指定して探す道具なので、1 段目の代わりにはなりません。
※ plan を動かすロールには、取り込む種類を読む権限が要ります。provider は種類ごとに多くの読み取りの API を呼ぶので、絞ったロールで本当に plan まで通るかは、実際に動かして確かめます(後の表の verify_restricted_plan.py)。
取り込む / 取り込まないの線引き
線引きの方針は、次の一文にまとめました。
アプリを再現・運用するための固定のリソースは Terraform に集める。組織で管理している基盤と、アプリが実行中に作ったり書き換えたりするものは、今の管理元のままにする。
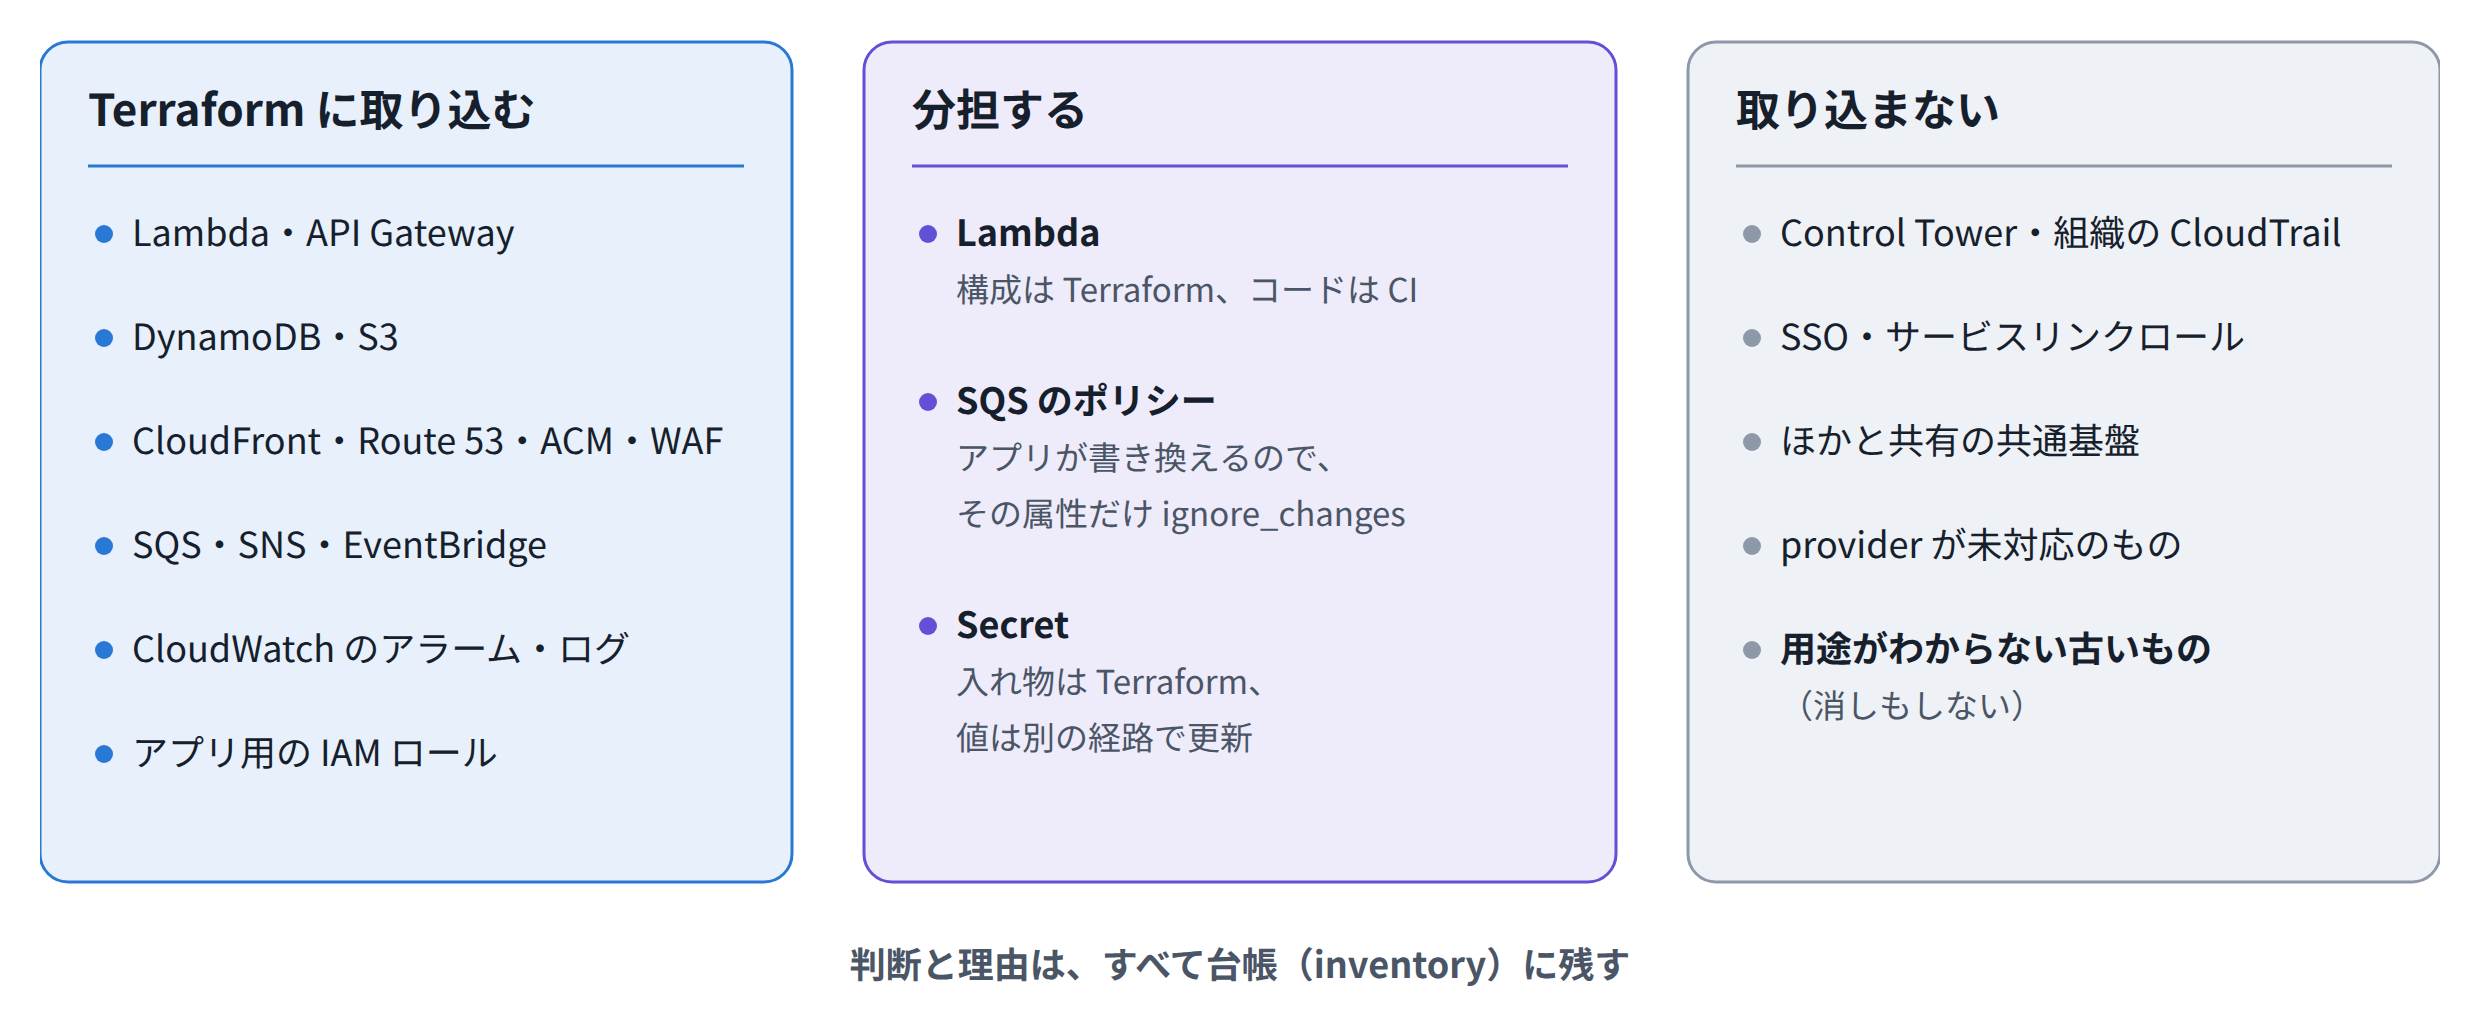
対象 | 判断 | 理由 |
|---|---|---|
Lambda、API Gateway、DynamoDB、S3、CloudFront、Route 53、ACM、WAF など | 取り込む | アプリを動かす固定のリソース |
CloudWatch のアラーム、ダッシュボード、ロググループ | 取り込む | IaC の外で手作業で作られていた運用の監視も含める |
Control Tower、組織の CloudTrail、SSO、サービスリンクロール | 取り込まない | 組織や AWS が管理するもの |
ほかのスタックも使う共通の基盤 | 取り込まない | 自分たちのアプリだけのものではない |
Well-Architected の workload | 取り込まない(保護して残す) | 採用した AWS provider(6.63.0)にリソースがない |
用途がわからない古い CloudFront と S3 | 取り込まない・消さない | 確証がないまま動かさない |
アプリが書き換える SQS のポリシー | キューは取り込み、policy だけ | アプリと Terraform で二重に管理しない |
Lambda | 構成は Terraform、コードはアプリの CI |
|
Secret | 入れ物だけ取り込む。値は持たない | 値を state に入れない |
ignore_changes は、範囲を属性 1 つに絞りました。Lambda なら「コード」だけを無視し、環境変数、ロール、タイムアウトは Terraform で管理します。広く無視すると、Terraform の外で設定が変わっても気づけなくなります。
「用途がわからないものは消さない」は、あとで効きました。本番には、用途のわからない古い資格情報が残っていて、不要に見えましたが、一括では消さずに残しました。運用を始める前に調べ直すと、今も使われているもので、保護する対象になりました。
判断はすべて、台帳(inventory.md)に「対象 / 判断 / 理由・持ち主」の形で残しました。あとで「なぜこれは Terraform にないのか」と聞かれたときに、答えられるようにするためです。
差分ゼロの定義を作る
取り込みの目標は、plan が「import N 件、追加 0、変更 0、削除 0」になることです。
定義は、実環境の値で書きました。GSI、Stream、TTL、暗号化、保持期間、IAM、イベントの接続、CloudFront の設定までです。そのうえで、import するリソースの一覧(manifest)を作りました。
最初の plan には、差分がいくつか出ました。中身は、provider が生成する空の設定ブロックや既定値と、調査ロールの読み取り権限が足りずに取れなかった設定でした。どちらも、実物を変えるための差分ではありません。定義の側をそろえ、権限を足して取り直して、差分を消しています。
※ 取り込みのあいだは、provider の default_tags を外しておくと安全です。付けたままだと、既存のリソースにタグを足すことになり、それが差分になります。
※ 1 つの S3 バケットでも、本体、ポリシー、暗号化、バージョニングなどで複数の Terraform リソースに分かれます。なので、件数は AWS 上の数とは一致しません。本番の 208 件で多かったのは、Route 53 のレコード 31、CloudWatch のアラーム 21、Lambda の permission 12 でした。
plan は別のスクリプトでも検証する
plan を目で見るだけでなく、独立したスクリプトでも検証しました。次のどれかに当たると失敗させます。
- import の最中に、no-op 以外の変更がある
- 削除や置換がある
- manifest にあるのに import されない、または manifest にないものが import される
- plan がエラーになっている、または不完全(deferred)
例外は 1 つだけです。Secret の「sensitive かどうか」の表示だけが変わる差分は、変更前と変更後の値が完全に一致することを確かめたうえで通します。
不完全な調査から作った plan は使わない
本番で、一度これに当たりました。Lambda の環境変数が KMS で暗号化されていて、調査用のロールでは中身を取れなかったのです。Terraform は、取れなかった環境変数を「環境変数なし」として扱います。そのままでは、正しく確かめたことになりません。
この plan は、使用禁止として隔離しました。そのうえで、調査ロールに kms:Decrypt を一時的に付けることにしました。
環境変数に秘密が入っているかもしれないので、私が明示的に承認してから付けました。条件は 2 つです。
- 対象のキーは 1 本だけ
- Lambda のサービスを経由した呼び出しだけ(
kms:ViaService = lambda.ap-northeast-1.amazonaws.com)
Secrets Manager の値を取ることは、引き続き禁止しました。調べ直したらすぐに例外を外し、kms:Decrypt を全面的に Deny する状態に戻しています。
読んだ結果、アプリの Lambda 7 関数の環境変数には、秘密らしい値や Slack の URL の直書きはなく、Secret は ARN か名前で参照していました。あわせて、環境変数が取れなかったときは調査を止めるチェックも足しています。
定義の自動生成は、初回だけ
定義は最初、調査の結果から自動で生成しました。ただ、取り込んだあとに生成し直すと、初回の設定に戻ってしまいます。生成スクリプトには「取り込み済みの環境では動かない」ガードを入れ、以後はレビューした Terraform を直接編集する運用にしました。
共通のモジュールに移ったあとも、生成スクリプトは「初回の生成に使った履歴」として残しています。生成先を新しいモジュールに付け替えることはしていません。付け替えると、古い生成の処理で共通の定義を上書きしかねないからです。
取り込む前に、止める・残す
取り込みの最中に、古い仕組みから設定が変わると、どちらが正しいのかわからなくなります。なので、先に止めました。
- 古いデプロイの workflow を止めた(dev は 11 本、本番は 7 本)
- 新しい仕組みのほうも、
deployment_ready = falseのあいだは、アプリの配布と Secret の更新を拒否するようにした - DynamoDB のバックアップを取った(dev は 7 テーブル、本番は 3 テーブル)
- 動いている Lambda のコードを保存した(dev は 13 関数、本番は 7 関数)。SHA256 と、保存先のバージョンも確かめた
戻し方も、段階ごとに先に書いておきました。
起きたこと | 戻し方 |
|---|---|
import の途中で止まった | state の一覧、AWS の実物、manifest を突き合わせ、新しい plan で残りを取り込む。古い plan を当て直さない |
state が壊れた | runner を全部止め、S3 に残っている古いバージョンを取り出して lineage と serial を確かめ、正式な手順で戻す |
データが壊れた | バックアップを別名のテーブルに戻して中身を確かめる。稼働中のテーブルは自動で消さない |
コードが壊れた | 保存した SHA256 とバージョンのコードを、同じ関数に戻してハッシュを照合する |
どの場合も、state を手で編集しないと決めました。
state の基盤
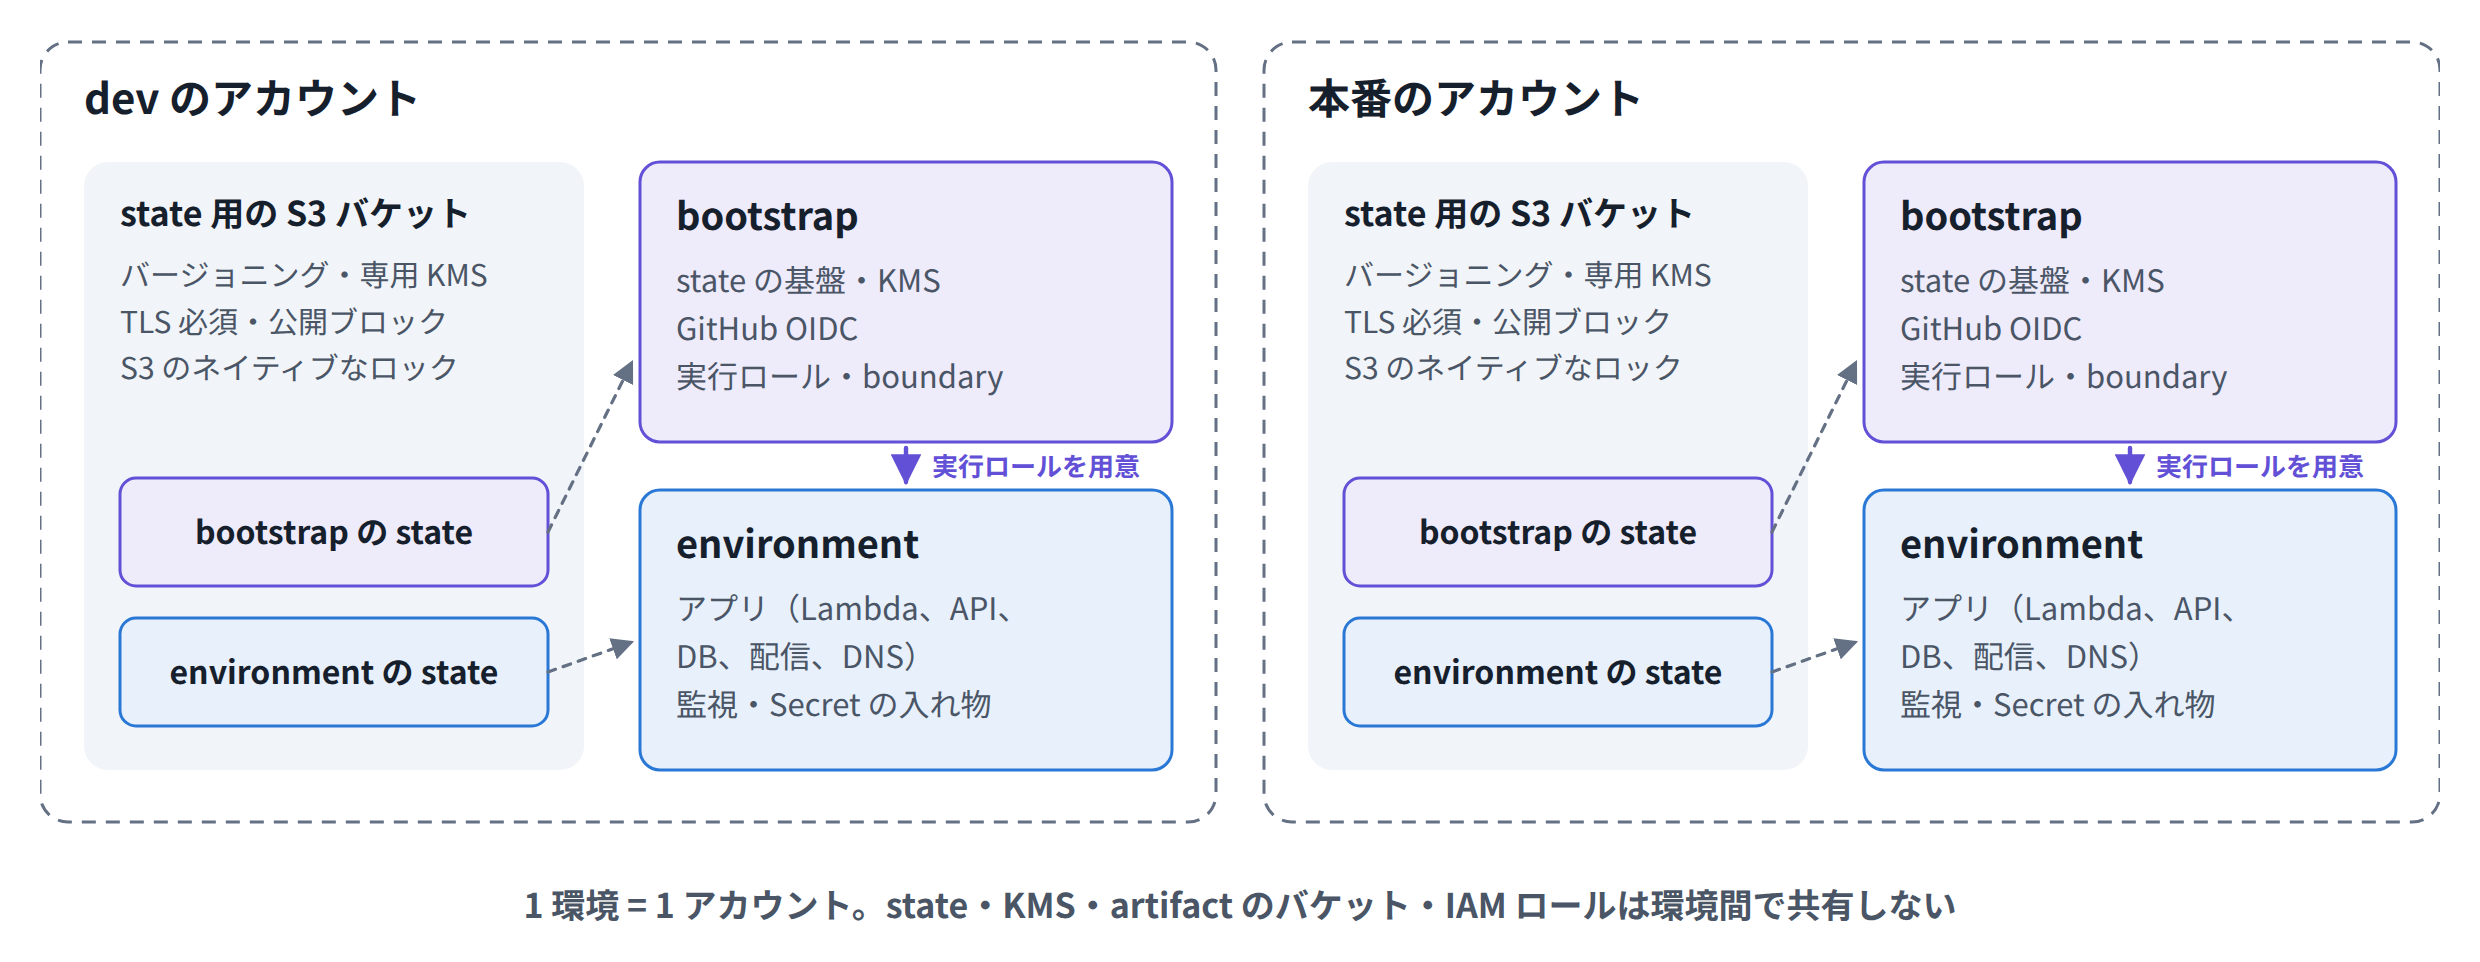
state は、アカウントごとに分けました(dev と本番は別のアカウントです)。さらに 1 つのアカウントの中でも、2 つに分けています。
- bootstrap:state を置く S3、KMS、GitHub OIDC、実行ロール、permissions boundary
- environment:アプリと、運用の基盤
分けたのは、普段の apply に使うロールが、自分の権限や state の置き場所を変えられないようにするためです。
state のバケットには、バージョニング、専用の KMS キー、Public Access Block、TLS 必須、削除防止、S3 のネイティブなロック(use_lockfile)を設定しました。
It is highly recommended that you enable Bucket Versioning on the S3 bucket to allow for state recovery in the case of accidental deletions and human error.
bootstrap には「鶏と卵」の問題があります。state を置くバケットを、バケットがまだない状態で作るからです。最初はローカルの state で bootstrap を作り、そのあと terraform init -migrate-state で S3 に移しました。
bootstrap で作ったのは、dev が新規 40 件(既存のリソースにはタグを足しただけ)、本番が新規 52 件です。本番は、既存の GitHub OIDC プロバイダー 1 件も import しました。どちらも、既存のリソースの削除は 0 件です。
ポイント:apply の前に state を退避して、CI の artifacts に上げる設定は見落としやすいところです。state や plan には秘密が入ることがあります。artifacts ではなく暗号化した S3 に置き、CI には参照(キー、VersionId、ハッシュ)だけを渡します。
本番の権限の当て方
本番でいちばん気を使ったのが、権限です。
作業用の限定ロールを作って、それを使う
Terraform 化の前に、作業用の限定ロールを作るところから始めました。調べる、基盤を作る、取り込む、と目的ごとにロールを分け、それぞれに必要な権限だけを持たせます。人が手元から作業するときも、このロールを引き受けて(AssumeRole)動かします。
ポイント:手元から管理者権限のまま apply すると、何ができて何ができないかが IAM で決まらず、操作の範囲を人の注意だけで守ることになります。管理者はロールを作るためだけに使い、作業は限定ロールで行います。
ロールは、SSO(IAM Identity Center)でログインした権限から引き受けます。たとえば ~/.aws/config をこうします。
[profile prod-sso]
sso_session = company
sso_account_id = <アカウント ID>
sso_role_name = <SSO の権限セット>

[profile prod-audit]
role_arn = arn:aws:iam::<アカウント ID>:role/<調査ロール>
source_profile = prod-sso
AWS_PROFILE=prod-audit で AWS CLI や Terraform を動かせば、ログインに使った権限ではなく、調査ロールの権限で動きます。調査ロールの信頼ポリシーでは、引き受けてよい相手を SSO のロールだけ(aws:PrincipalArn の ArnLike)に絞りました。
管理者で行ったのは、ロールを 2 つ作ることだけ
ロールを作る操作だけは、強い権限が要ります。管理者の認証情報を使ったのは、名前付きの IAM ロールを 2 つ作る操作だけでした。管理者権限で Terraform を直接実行してはいません。
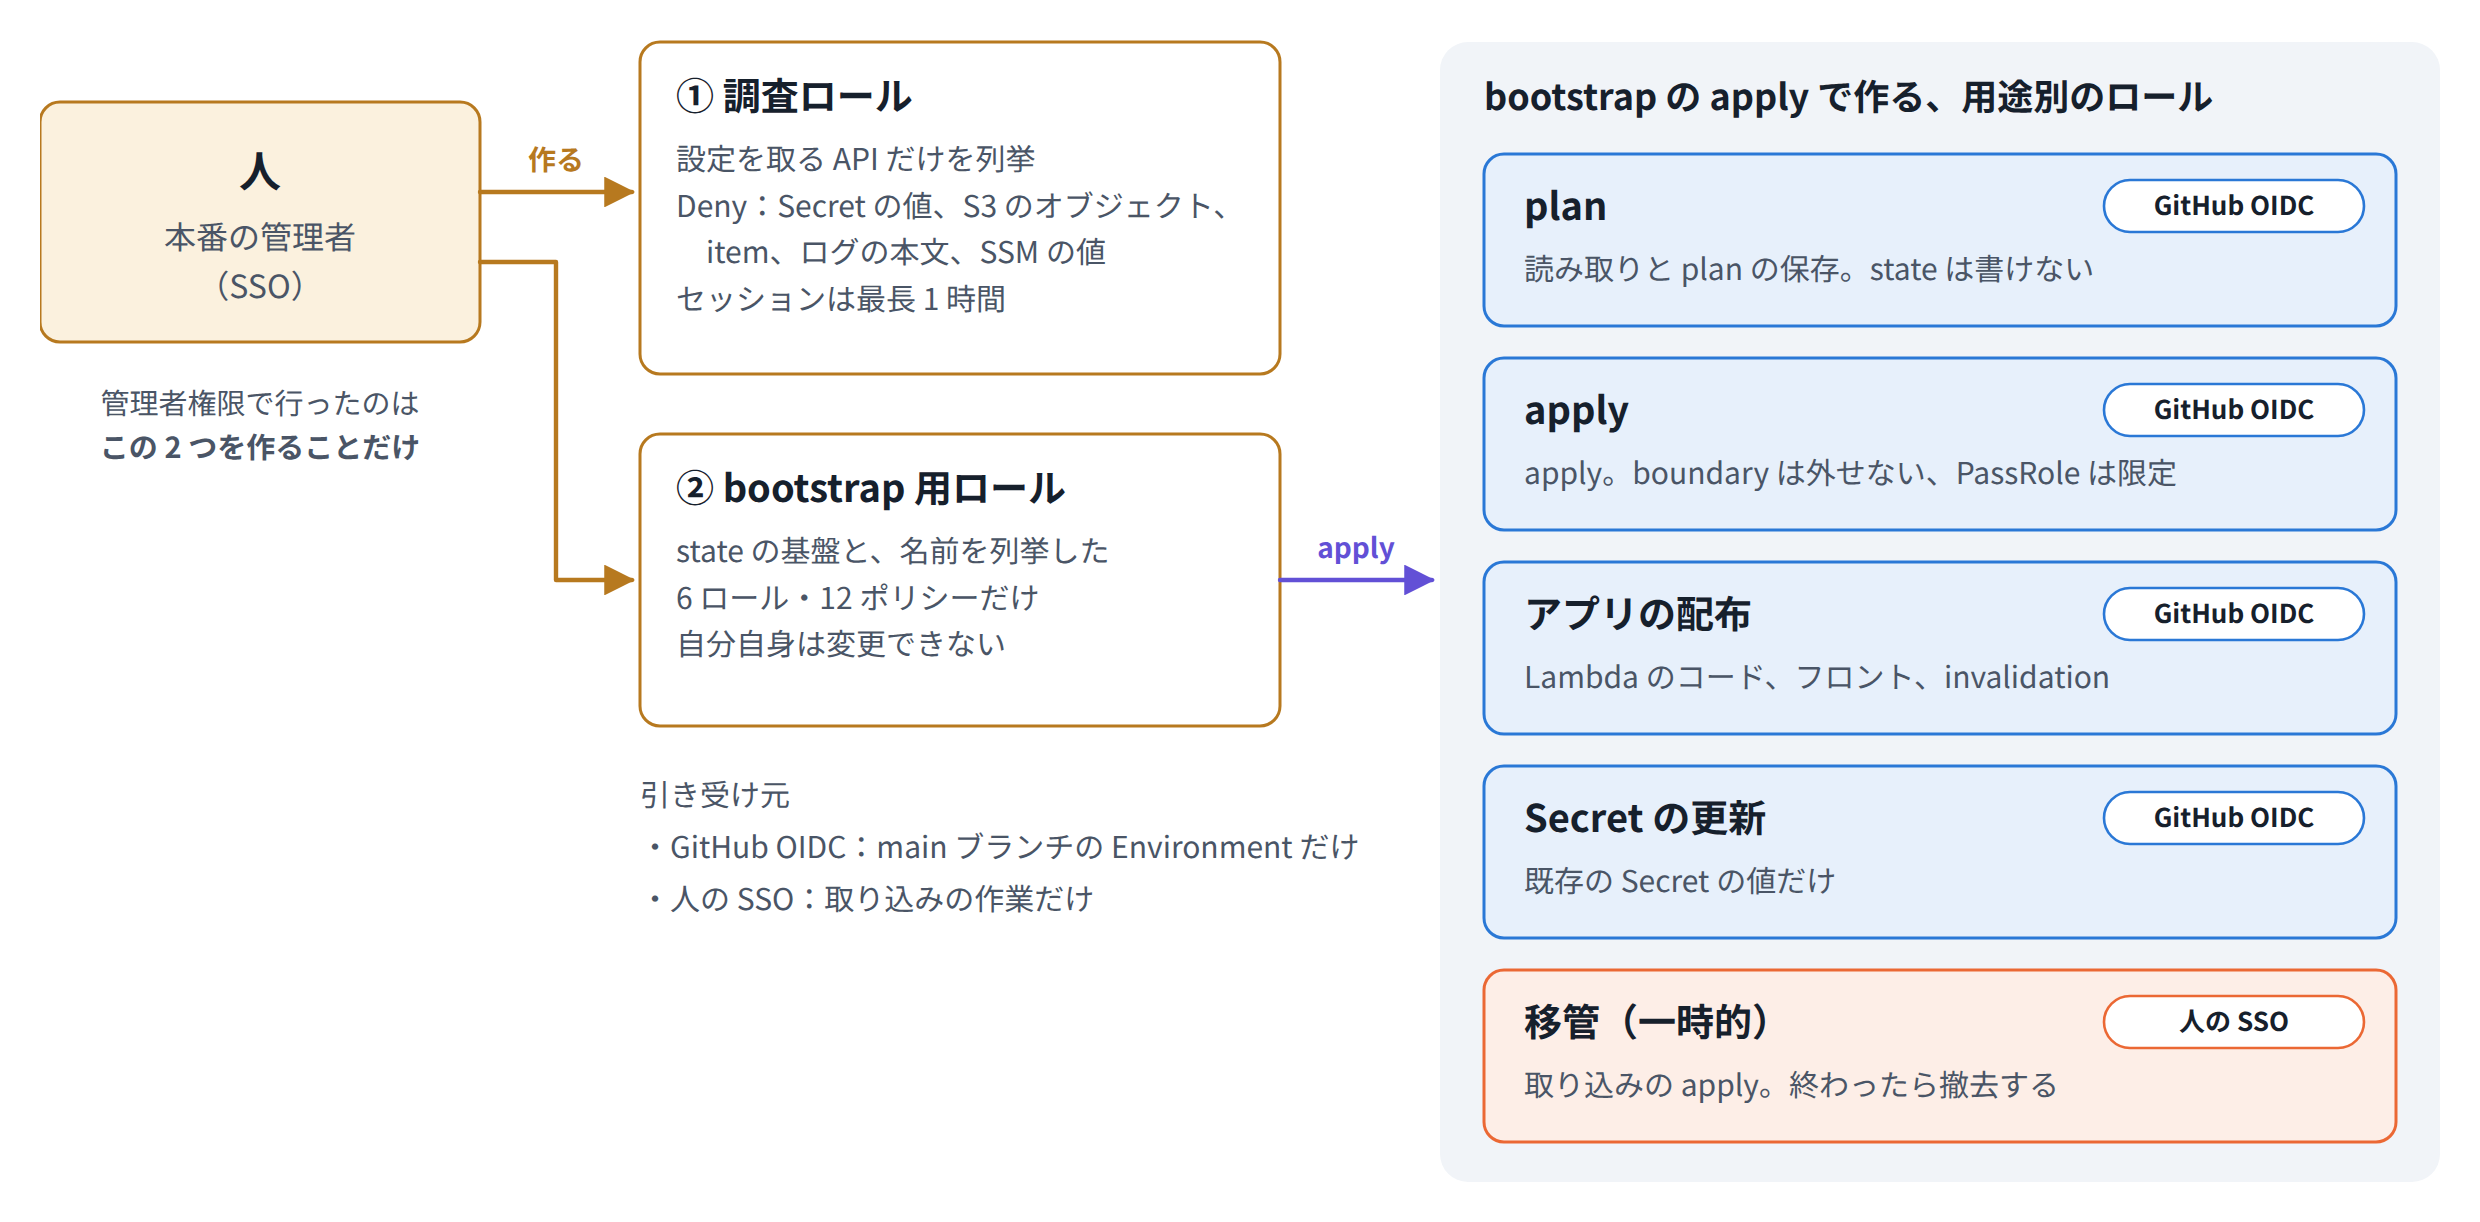
順番はこうです。
順 | 段階 | 使った権限 | ポイント |
|---|---|---|---|
1 | 権限セットを設計する | (AWS は変えない) | dev の実構成をもとに、用途別の権限と絞り込みの手順を先に文書にした。dev の ARN を機械的に置き換えて本番に使わない、本番の値は調べてから決める、と決めておいた |
2 | 調査ロールを作る | 管理者(このロールを作るだけ) | 読めるのは設定だけ |
3 | 調べる | 調査ロール | 上の |
4 | bootstrap 用のロールを作る | 管理者(このロールを作るだけ) | 名前を列挙したロールとポリシーしか触れない |
5 | bootstrap を apply する | bootstrap 用のロール | state の基盤、用途別のロール、権限、boundary がここでできる |
6 | 取り込む | 移管用のロール | GitHub Actions からではなく、人の SSO ロールから引き受けた |
調査ロール:読めるのは設定だけ
AWS 管理のポリシーは、どちらもちょうどよくありませんでした。
- ViewOnlyAccess では足りない。IAM ロールの詳細(
iam:GetRole)や、EventBridge の API destination の一覧(events:ListApiDestinations)など、取り込みに要る読み取りが拒否された - ReadOnlyAccess では広すぎる。アプリのデータまで読めてしまう
なので、調査ロールは自分で作りました。
- 設定を取る API を、明示して列挙する
- 次の読み取りは、Deny で明示的に禁止する
- Secret の値
- S3 のオブジェクト
- DynamoDB の item
- ログの本文
- SSM パラメータの値
- 信頼するのは、本番の SSO のロールだけ(
ArnLikeの条件)。セッションは最長 1 時間
※ Lambda の GetFunction は、コードのダウンロード URL も返します。「設定の読み取り」のつもりでも、コードは読める点に注意が必要です。
bootstrap 用のロール:名前を列挙したものだけ
- 触れるのは、state と artifact のバケット、タグの条件付きの KMS 操作、bootstrap の state のキーだけ
- IAM は、名前を列挙した 6 つのロールと 12 のポリシーの ARN だけ。
AttachRolePolicyも、自分が作ったポリシーの ARN に限る - 自分自身は変更できない
最初の案は、既存のデプロイ用ロールの変更と、ワイルドカードを使ったポリシーの管理まで含んでいました。広すぎるので、新しく作るロールとポリシーの名前を完全一致で列挙する形に絞り直しています。
用途ごとのロール
ロール | 引き受け元 | できること | 持たせないもの |
|---|---|---|---|
plan | GitHub OIDC(plan 用の Environment) | 読み取り、state の読み取り、plan の保存 | state への書き込み |
apply | GitHub OIDC(本番の Environment) | 読み取りと apply。ポリシーは IAM / compute / data / edge / events / backup の 6 つに分けた | boundary の変更。 |
アプリの配布 | GitHub OIDC | Lambda のコード更新、フロントの配置、CloudFront の invalidation | インフラの作成、IAM、Secret の値 |
Secret の更新 | GitHub OIDC(Secret 用の Environment) | 既存の Secret 4 種類の値の更新 | インフラの操作 |
移管(一時的) | 人の SSO ロール | 読み取り、state の書き込み、対象テーブルのバックアップ | 列挙した以外のスタック、テーブル、アカウント |
GitHub の Environment は、main ブランチからしか使えないように絞りました。
ポイント:CI のロールは、手順書に名前を書くだけでなく、Terraform の定義に入れます。コードにあれば、権限をレビューでき、Access Analyzer で機械的にも検証できます。
apply 用のロールは、作るロールに permissions boundary を付けることはできますが、外すことはできません。
A permissions boundary is an advanced feature for using a managed policy to set the maximum permissions that an identity-based policy can grant to an IAM entity.
ほかに気をつけたこと
- PassRole の渡し先を絞る。管理者相当のロールを渡せるなら、渡せる側も実質的に管理者です。元の IaC ツールの実行ロールは権限が広かったので、移管用のロールが渡せる相手は、読み取り専用の専用ロール 1 つに固定しました。
- 適用する前に、ポリシーを機械で検証する。IAM Access Analyzer の
ValidatePolicyで ERROR がないことを確かめてから適用します。ただし、これは構文と action の確認です。必要な操作がそろっているかまでは保証しません。 - 既存のロールを黙って上書きしない。同じ名前のロールの信頼ポリシーが想定と違えば、上書きせずに止まります。
- 例外は、撤去まで含めて 1 つの手順にする。付けるときに、外すタイミングも決めておきます。
- 足りない権限は、実際に動かしてわかる。本番の配布を有効にしたときに、
kms:GenerateDataKeyとlambda:GetFunctionの不足が見つかり、直しました。
apply の守り
権限を分けるだけでなく、apply できる状況そのものをスクリプトで絞りました。
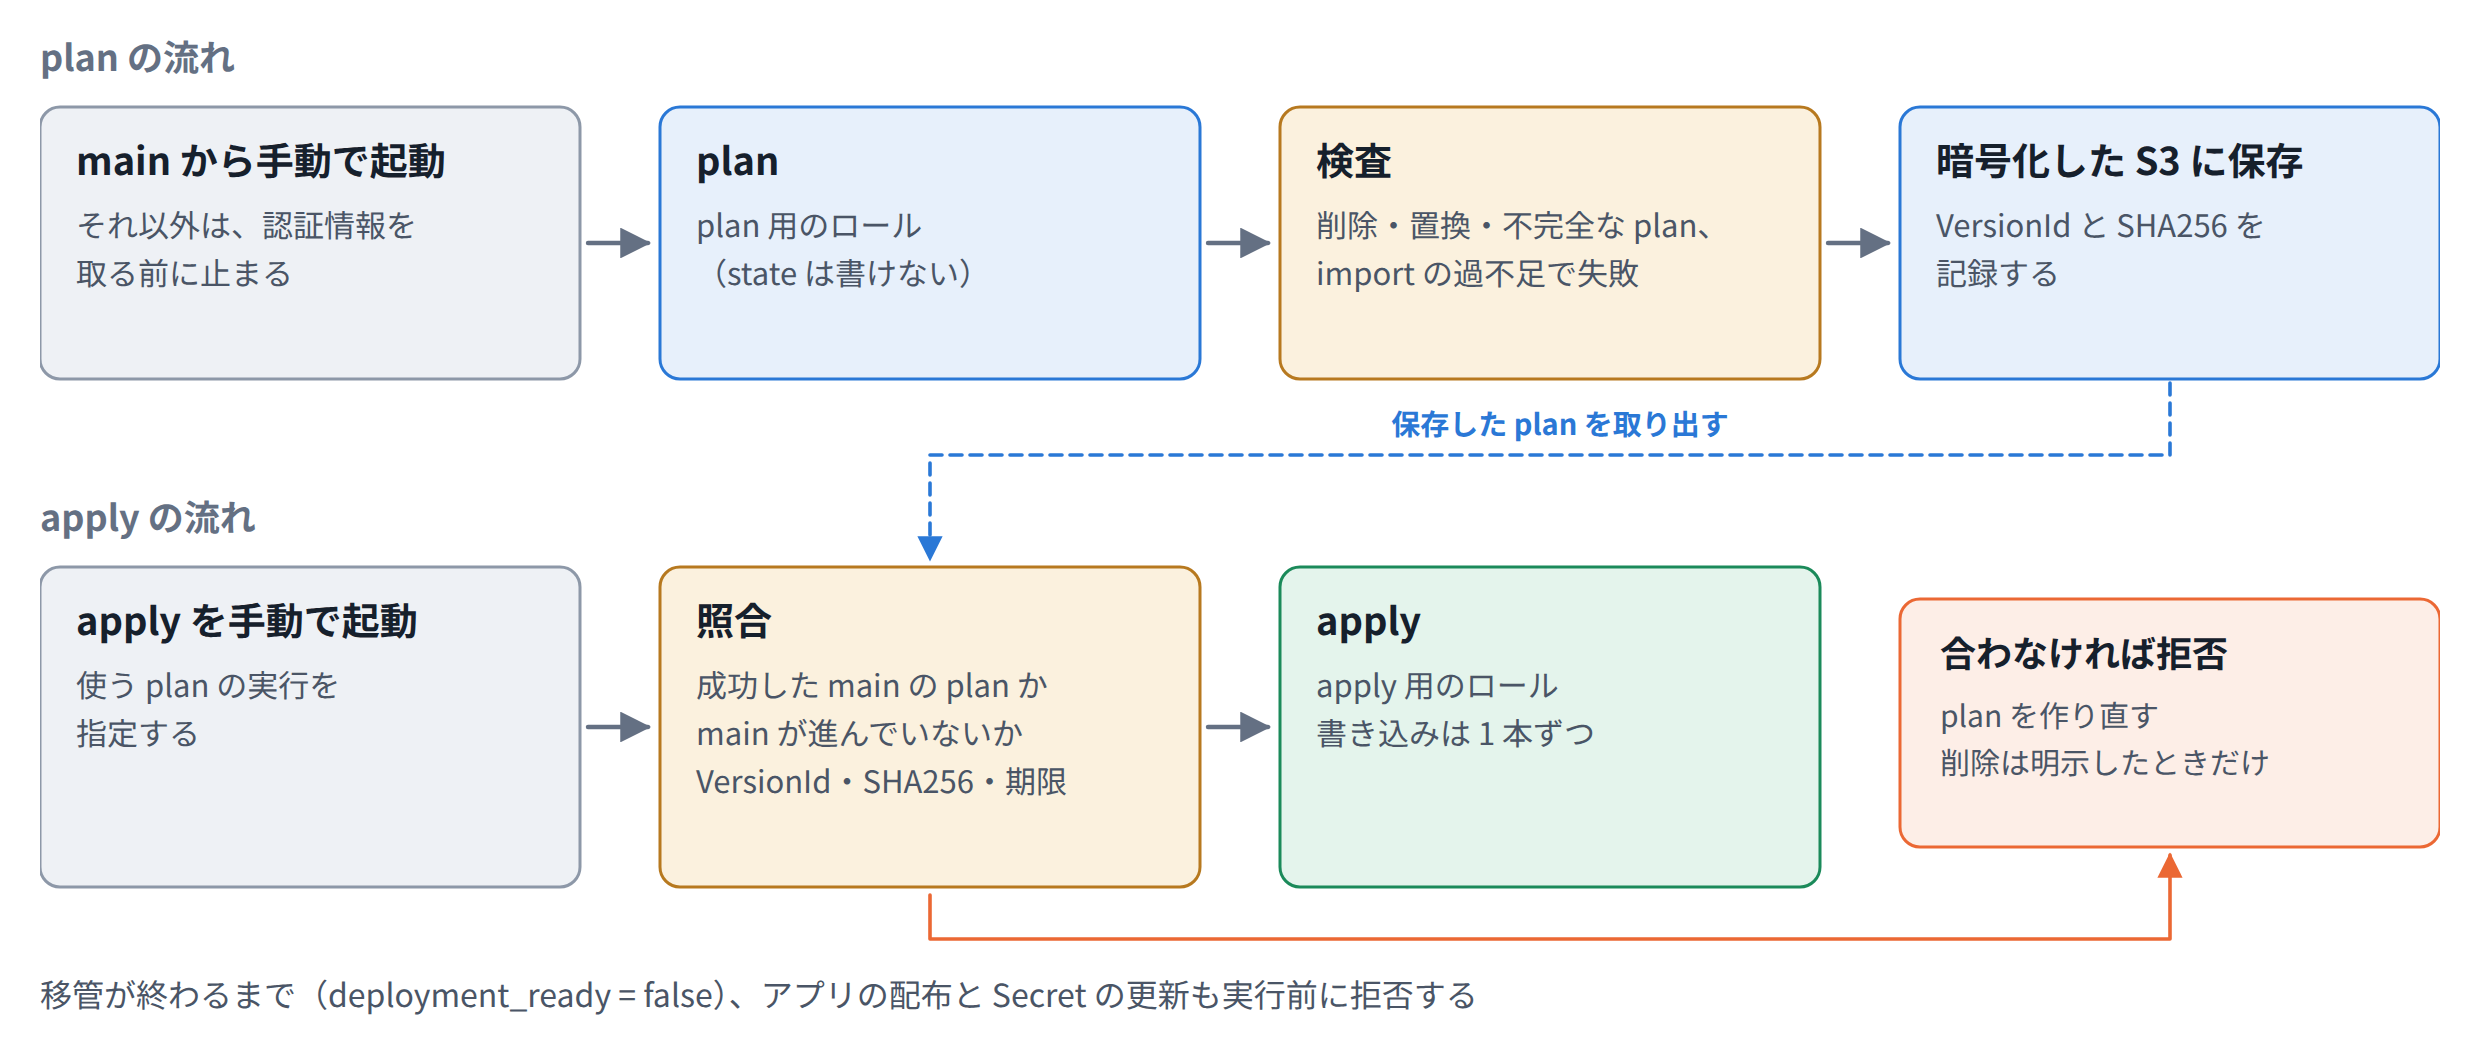
- main から手動で起動したときだけ。
workflow_dispatchかつrefs/heads/mainでなければ、認証情報を取る前に止まります。 - plan と apply でロールを分ける。plan は state を書けないロール、apply は別のロールです。書き込みは 1 本ずつ直列に流します。
- apply できるのは、成功した main の plan だけ。指定された plan の実行が、同じ workflow の手動実行で、main で、成功していることを GitHub API で確かめます。
- plan のあとに main が進んでいたら、拒否する。plan のときのコミットと、apply のときの
GITHUB_SHAが一致しなければ、plan を作り直します。 - plan が同じものか、S3 の VersionId と SHA256 で確かめる。期限を過ぎた plan も使いません。
- 削除と置換は、既定で拒否する。必要なときだけ明示的に許可します。DynamoDB、S3、Secret、証明書、DNS のゾーンには
prevent_destroyも付けています。 - 移管が終わるまで、アプリと Secret は動かせない。
deployment_ready = falseのあいだは、実行する前に拒否されます。
ポイント:apply の直前に plan を作り直す workflow は、レビューした plan と同じものを apply するとは限りません。そのあいだに main や実物が変わっていれば、中身も変わります。apply するのは、保存してレビューした plan だけにします。
確認はスクリプトにして、結果を JSON に残す
取り込みの前後で確かめることは、手順書に書くのではなく、スクリプトにしました。手順書のチェックは、抜けても誰も気づけません。スクリプトなら、合わないところで止まります。
ポイント:手順書に書いた仕組み(CI の workflow、承認のゲート、ロール)は、書いただけでは動いているかわかりません。CI が一度でも最後まで通ったか、ゲートとロールが実際に作られているかまで確かめます。
いつ | スクリプト | 確かめること |
|---|---|---|
毎回、最初に |
| 認証情報が、狙ったアカウントのものか。dev の設定で本番のアカウントを指していたら止める(逆も止める) |
調査 |
| 実環境を読み取りだけで調べる。生データは Git 管理外に置く |
取り込む前 |
| DynamoDB のバックアップと、動いている Lambda のコードを保存する |
plan のあと |
| no-op 以外の変更、削除・置換、import の過不足、不完全な plan がないか |
plan のあと |
| plan に入る IAM ポリシーを Access Analyzer で検証する。ポリシーの中身は画面に出さない |
権限を絞ったあと |
| 絞ったロールで、実際に plan まで通るか |
state の基盤を作ったあと |
| state の置き場所を、実際に試す(下で説明) |
取り込んだあと |
| 前と後で、Lambda のコードのハッシュと ARN、DynamoDB の ID とスキーマ(GSI を含む)、公開 URL、SQS のポリシーが変わっていないか |
本番の apply の前 |
| main から手動で起動されたか、指定した plan と同じものか、移管が終わっているか |
アカウントの取り違えは、スクリプトだけでなく、Terraform の変数の validation でも止めています。dev の root は本番のアカウントと本番の環境名を受け付けず、本番の root は東京以外のリージョンを受け付けません。この validation は、11 のケースのテストで確かめました。
結果は JSON に書き出しました。レポートの HTML も、この JSON からスクリプトで作り直せるようにしています。次の節の表も、この記録をもとにしています。
state の置き場所を、実際に試す
state のバケットは、設定を読むだけでなく、実際に書いて試しました(verify_backend.py)。
- バージョニングが有効か
- state が、決めた KMS キーで暗号化されているか
- 同じ名前のファイルを「なければ作る」という条件付きで 2 回書き、2 回目が拒否されるか。S3 のネイティブなロックは、この条件付きの書き込み(
If-None-Match)を使っています - 上書きしたあとで、古いバージョンを取り出せるか
試しに使うファイルは state とは別の場所に作り、最後に消します。
ロックと戻し方は、設定が入っていても、実際に動くかは試すまでわかりません。手順書に「古いバージョンから戻せる」と書いてあっても、試されていないことが多いところだと思います。
確認用のスクリプトにもテストを付ける
確認用のスクリプトそのものが間違っていると、「問題なし」と出てしまいます。なので、スクリプトにもテストを付けました。たとえば Trivy を動かすシェル(trivy_scan.sh)には、テスト用のシェル(test_trivy.sh)があります。わざと設定を緩めた定義を読ませて、検査がちゃんと失敗することを確かめています。
取り込んだあとの照合
確かめたこと | dev | 本番 |
|---|---|---|
import の結果 | 299 件 | 208 imported / 0 added / 0 changed / 0 destroyed |
取り込み後の plan | No changes | No changes(208 件すべて no-op) |
state と manifest | 一致 | 一致 |
公開画面と API の health | 6 / 6 が HTTP 200 | 5 / 5 が HTTP 200 |
Lambda の ID とコードのハッシュ | 一致(13 関数) | 一致(7 関数) |
DynamoDB の ID とスキーマ | 一致(7 テーブル) | 一致(3 テーブル) |
アプリが書き換える SQS のポリシー | 変わっていない | — |
確かめられなかったことも、記録に残しました。認証が必要な業務の流れ(登録や通知など)は、このときは動かしていません。
plan の No changes は、「Terraform の定義と実物が同じ」という意味です。「アプリが正しく動く」という意味ではないので、この 2 つは分けて書いています。
dev と本番を同じモジュールにする
取り込みの時点では、本番の定義を dev とは別に作りました。本番には dev にないもの(AWS Backup の設定、本番だけの通知用 Lambda)があり、逆に dev には本番にまだない機能が先に入っていました。dev の定義をそのまま当てると、本番を変えてしまいます。まずは本番の実物に合わせるのが先でした。
取り込んだあとで、dev と本番が同じモジュールを参照するようにまとめました。別々のままだと、dev で確かめた変更を本番用に書き直すことになり、本番の変更が dev で一度もリハーサルされません。
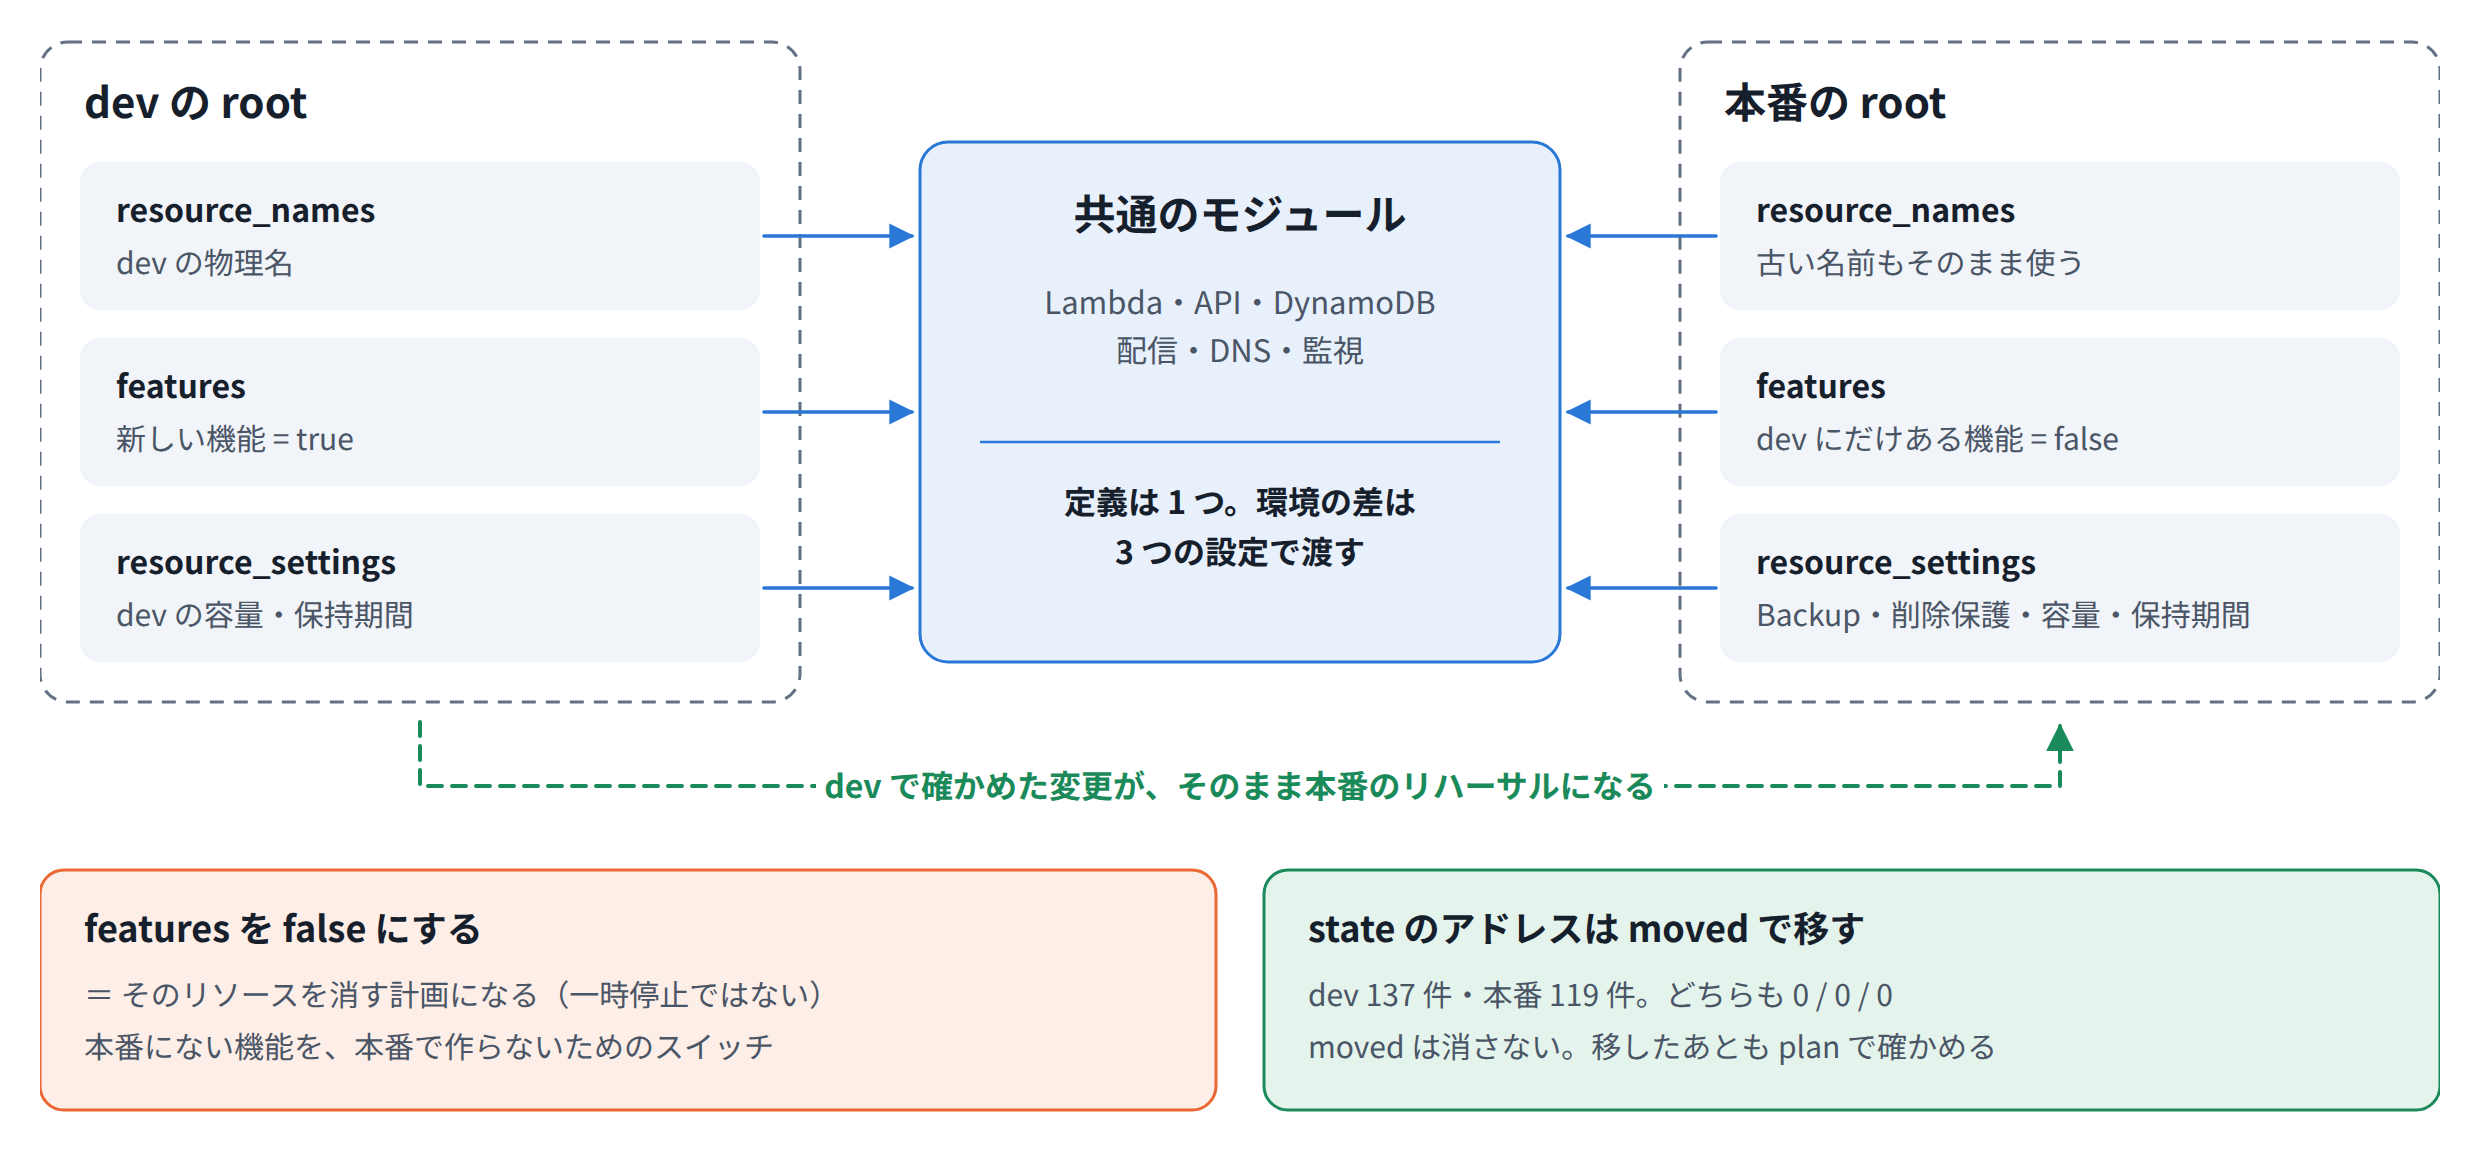
※ 環境の差(dev に先に入れた機能など、意図した差)と、drift(定義と実物のずれ)は別のものです。共通化で減らすのは定義の重複で、意図した差は設定として残します。
環境の差は、3 つの設定で表しています。
設定 | 中身 |
|---|---|
| 既存の物理名。本番の古い名前もそのまま使う |
| 導入する機能。dev にだけある機能は、本番では |
| 容量、保持期間、インデックス、タグなど、実際にある差だけ |
共通化の途中で、機能の有無だけでなく、本番だけのバックアップと削除保護、容量、ログの保持期間の違いも見つかりました。名前と機能のスイッチだけでは吸収できないので、resource_settings に入れています。また、dev の plan に置換の候補が 1 件出たので、直してから反映しました。実リソースに変更が出る状態では apply しません。
state 上のアドレスは moved ブロックで移しました。dev は 137 件、本番は 119 件で、どちらも追加・変更・削除は 0 件です。
moved は、アドレスを移して再作成を防ぐだけです。移動先の設定まで同じにしてくれるわけではないので、移したあとも plan で設定の差が出ていないことを確かめます。moved ブロックは、整理のつもりで消さないようにしています。
注意点が 2 つあります。
featuresをfalseにするのは「一時停止」ではなく、リソースを消す計画になる。本番にない機能を本番で作らないためのスイッチで、導入済みの機能を止めるためのものではありません。- 本番に機能を足すのは、別の変更にする。同じ機能を dev で有効にして確かめてから、必要なコード、Secret、外部との連携の設定と一緒に入れます。
dev 環境を増やすときは、1 環境 = 1 アカウントにしています。state、KMS、artifact のバケット、IAM ロール、DNS は共有しません。別アカウントの名前の組み立ては、モックのテストで確かめています。ただし、実アカウントで作ってみることの代わりにはなりません。
アプリの配布と Secret を切り離す
インフラ、アプリのコード、Secret の値は、それぞれ別の経路と別のロールで更新するようにしました。
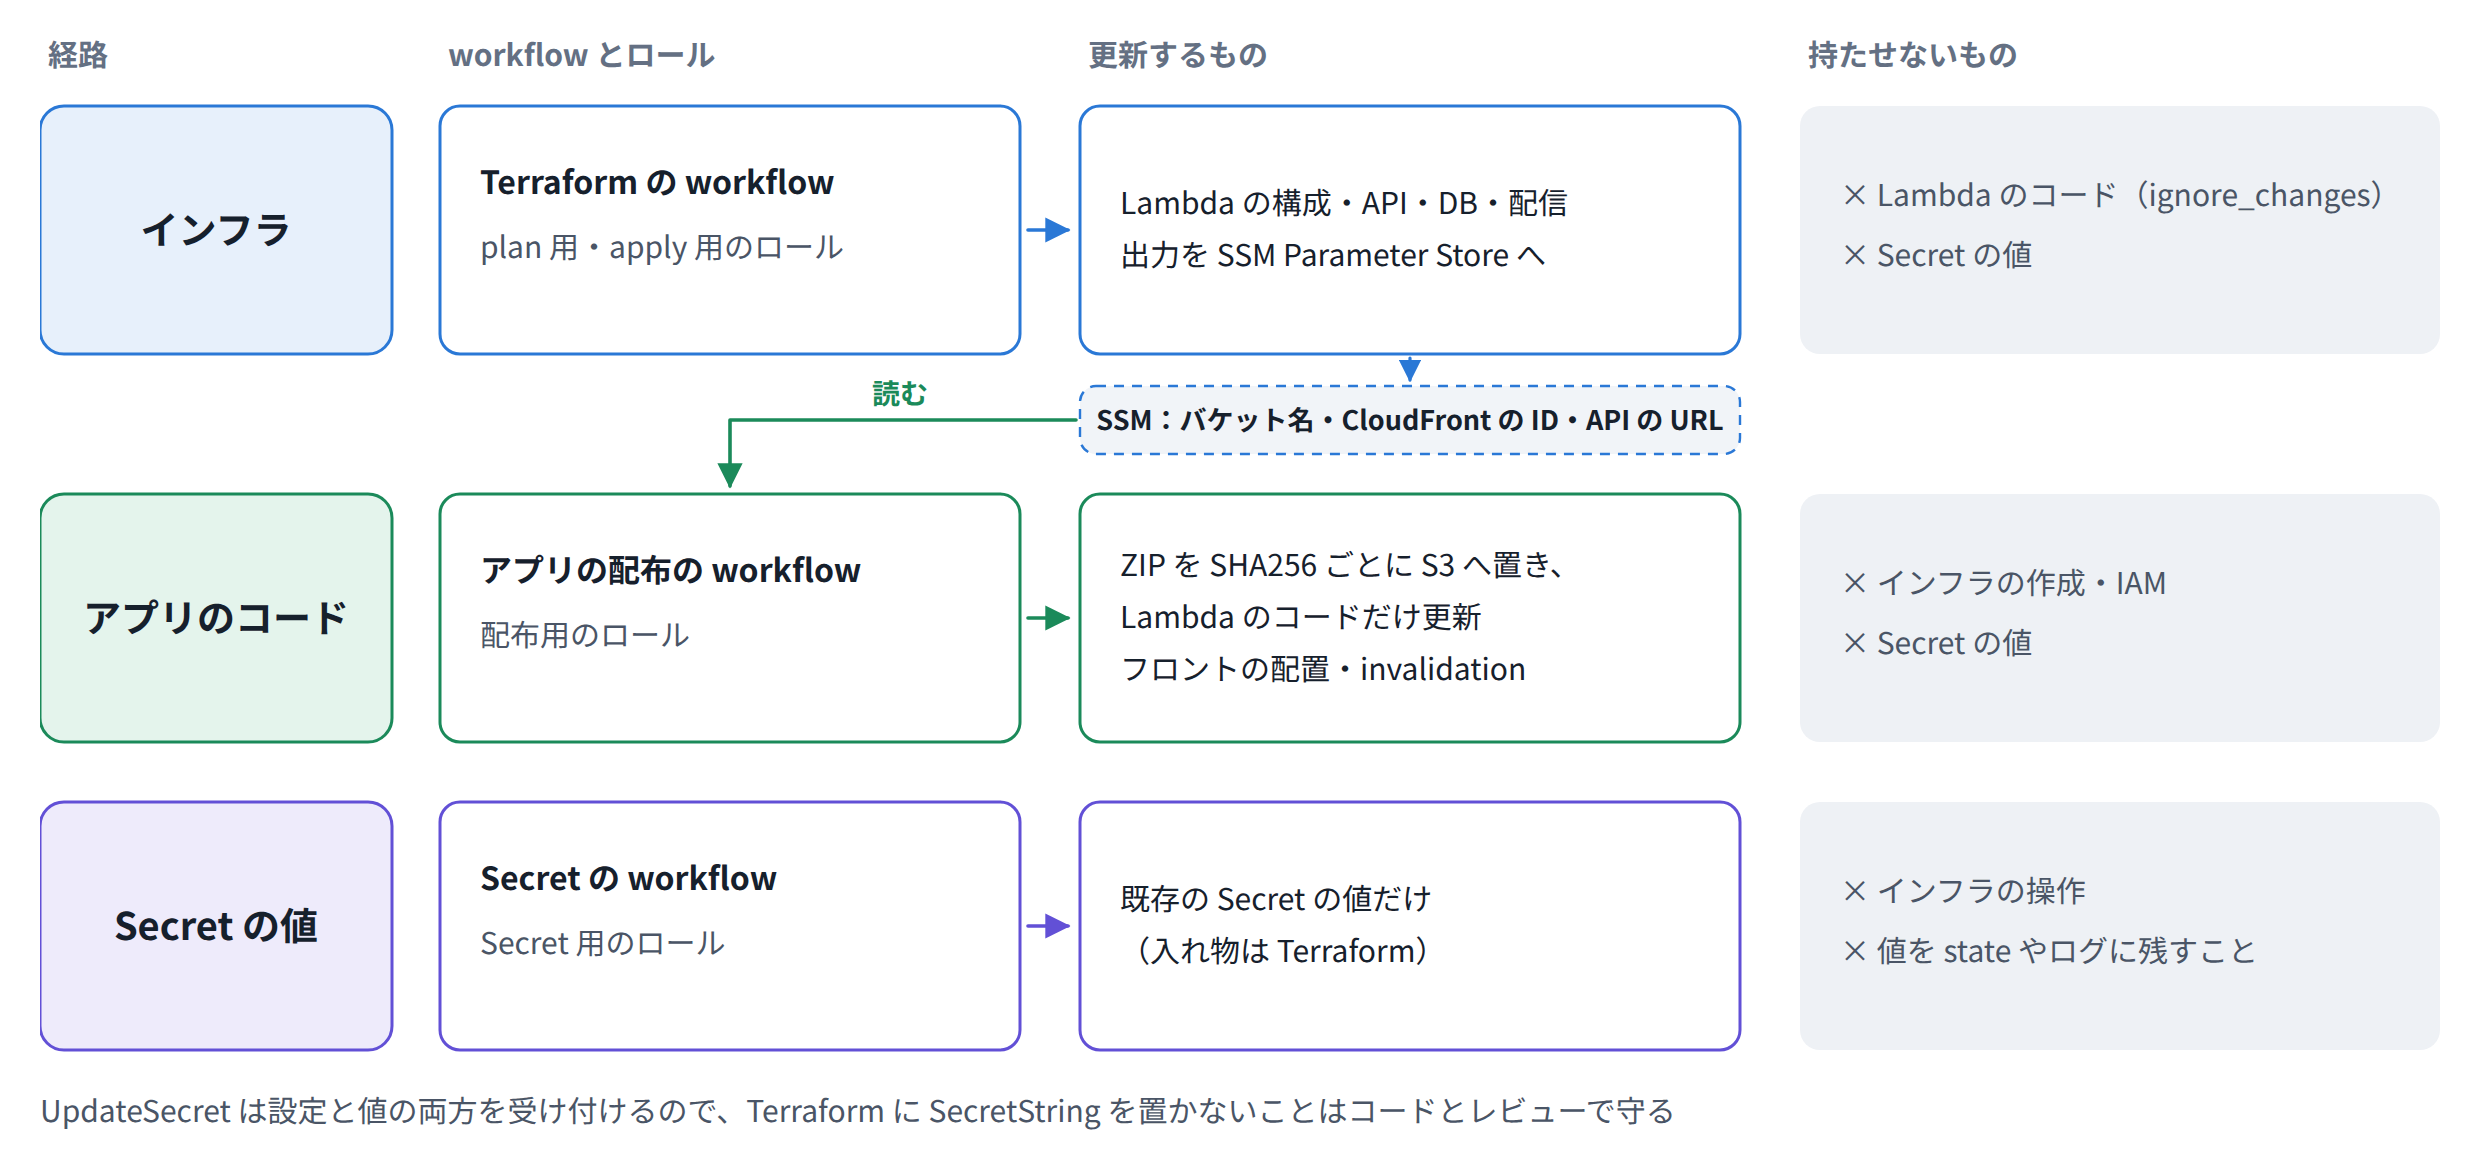
- Terraform の出力は SSM Parameter Store に置く。バケット名、CloudFront の ID、API の URL などです。アプリの配布はそこから読みます。
- Lambda のコードは、ビルドした ZIP を SHA256 ごとに S3 に置き、コードだけを更新する。同じコードなら更新しません。
- Secret の値は、専用の workflow とロールで更新する。値を Terraform、入力欄、ログ、state に持ち込みません。
※ Secrets Manager の UpdateSecret は、設定の変更と値の更新の両方を受け付けます。なので、IAM の action だけでは、値の更新を完全には分けられません。Terraform に SecretString を置かないことは、コードとレビューで守っています。
静的解析は「入れて終わり」ではなかった
静的解析(Trivy)も CI に入れました。詳しい比較は省いて、IaC 化に関係するところだけ書きます。
- ソースと plan の両方を検査する。ソースにはリソース同士の関係が残り、plan には実行時の値が入ります。役割が違います。
- 共通モジュールにすると、ソースの検査が効きにくくなる。設定の値を変数から入れる形(
try(var.resource_settings[...]))にしたので、スキャナが静的に値を決められません。実際、設定を直してもソースの検査の件数が変わりませんでした。そこで、マージを止める判定は plan の検査に移し、ソースの検査は報告だけにしました。 - 既存の指摘を、まとめて除外しない。除外は、中身を確かめて理由を書いたものだけ、ルール単位で数個です。
- 指摘どおりに直すと、壊れることがある。S3 を顧客管理の KMS キーで暗号化したら、匿名で配っている公開ファイルが HTTP 400 になりました。S3 の匿名アクセスは、KMS で暗号化したオブジェクトには使えません。公開用のバケットだけ SSE-S3 に戻しました。
- スキャナは隔離して動かす。ネットワークなし、AWS の認証情報なし、イメージは digest で固定しています。ただ、digest の固定は「選んだものを固定する」だけで、そのイメージが安全である証明にはなりません。
AI エージェントに任せるときの観点
作業は、AI エージェント(Codex)と進めました。任せるときに決めておいたことは、次のとおりです。
- 許可の範囲を、言葉ではっきり書く。どのブランチで作業し、マージ、apply、本番の操作のどこまでをやってよいか、を毎回書きました。main へのマージと元の管理ツールの撤去は、最後まで「実行する前に、人が確認する」条件にしています。
- 本番の強い権限は、AI の手の届くところに置かない。AI に渡したのは、上の作業用の限定ロールだけです。渡す認証情報が本当に弱いものかは、渡す側でも確かめます。
- 権限を広げるときは、人の承認、条件、撤去の 3 つをそろえる。上の
kms:Decryptの例外が、その例です。 - 完了の報告は、「何が終わって、何が残っているか」で確かめる。「取り込める」と「取り込んだ」は、報告の文面だと似て見えます。
- 記録は、機械が読める形で残させる。結果は JSON(取り込みの件数、検証の結果、まだやっていないこと)と HTML のレポートに残しました。終わっていないことは「終わっていない」と書かせ、残りは Issue に分けて追いかけています。生のデータ(調査の結果、plan、state)は Git に入れません。
IaC 化の観点まとめ
今やるなら、この流れで進める
今回やったことと、先に試したときや検証用の環境でわかったことを合わせて、今やるならこの順番で進めます。
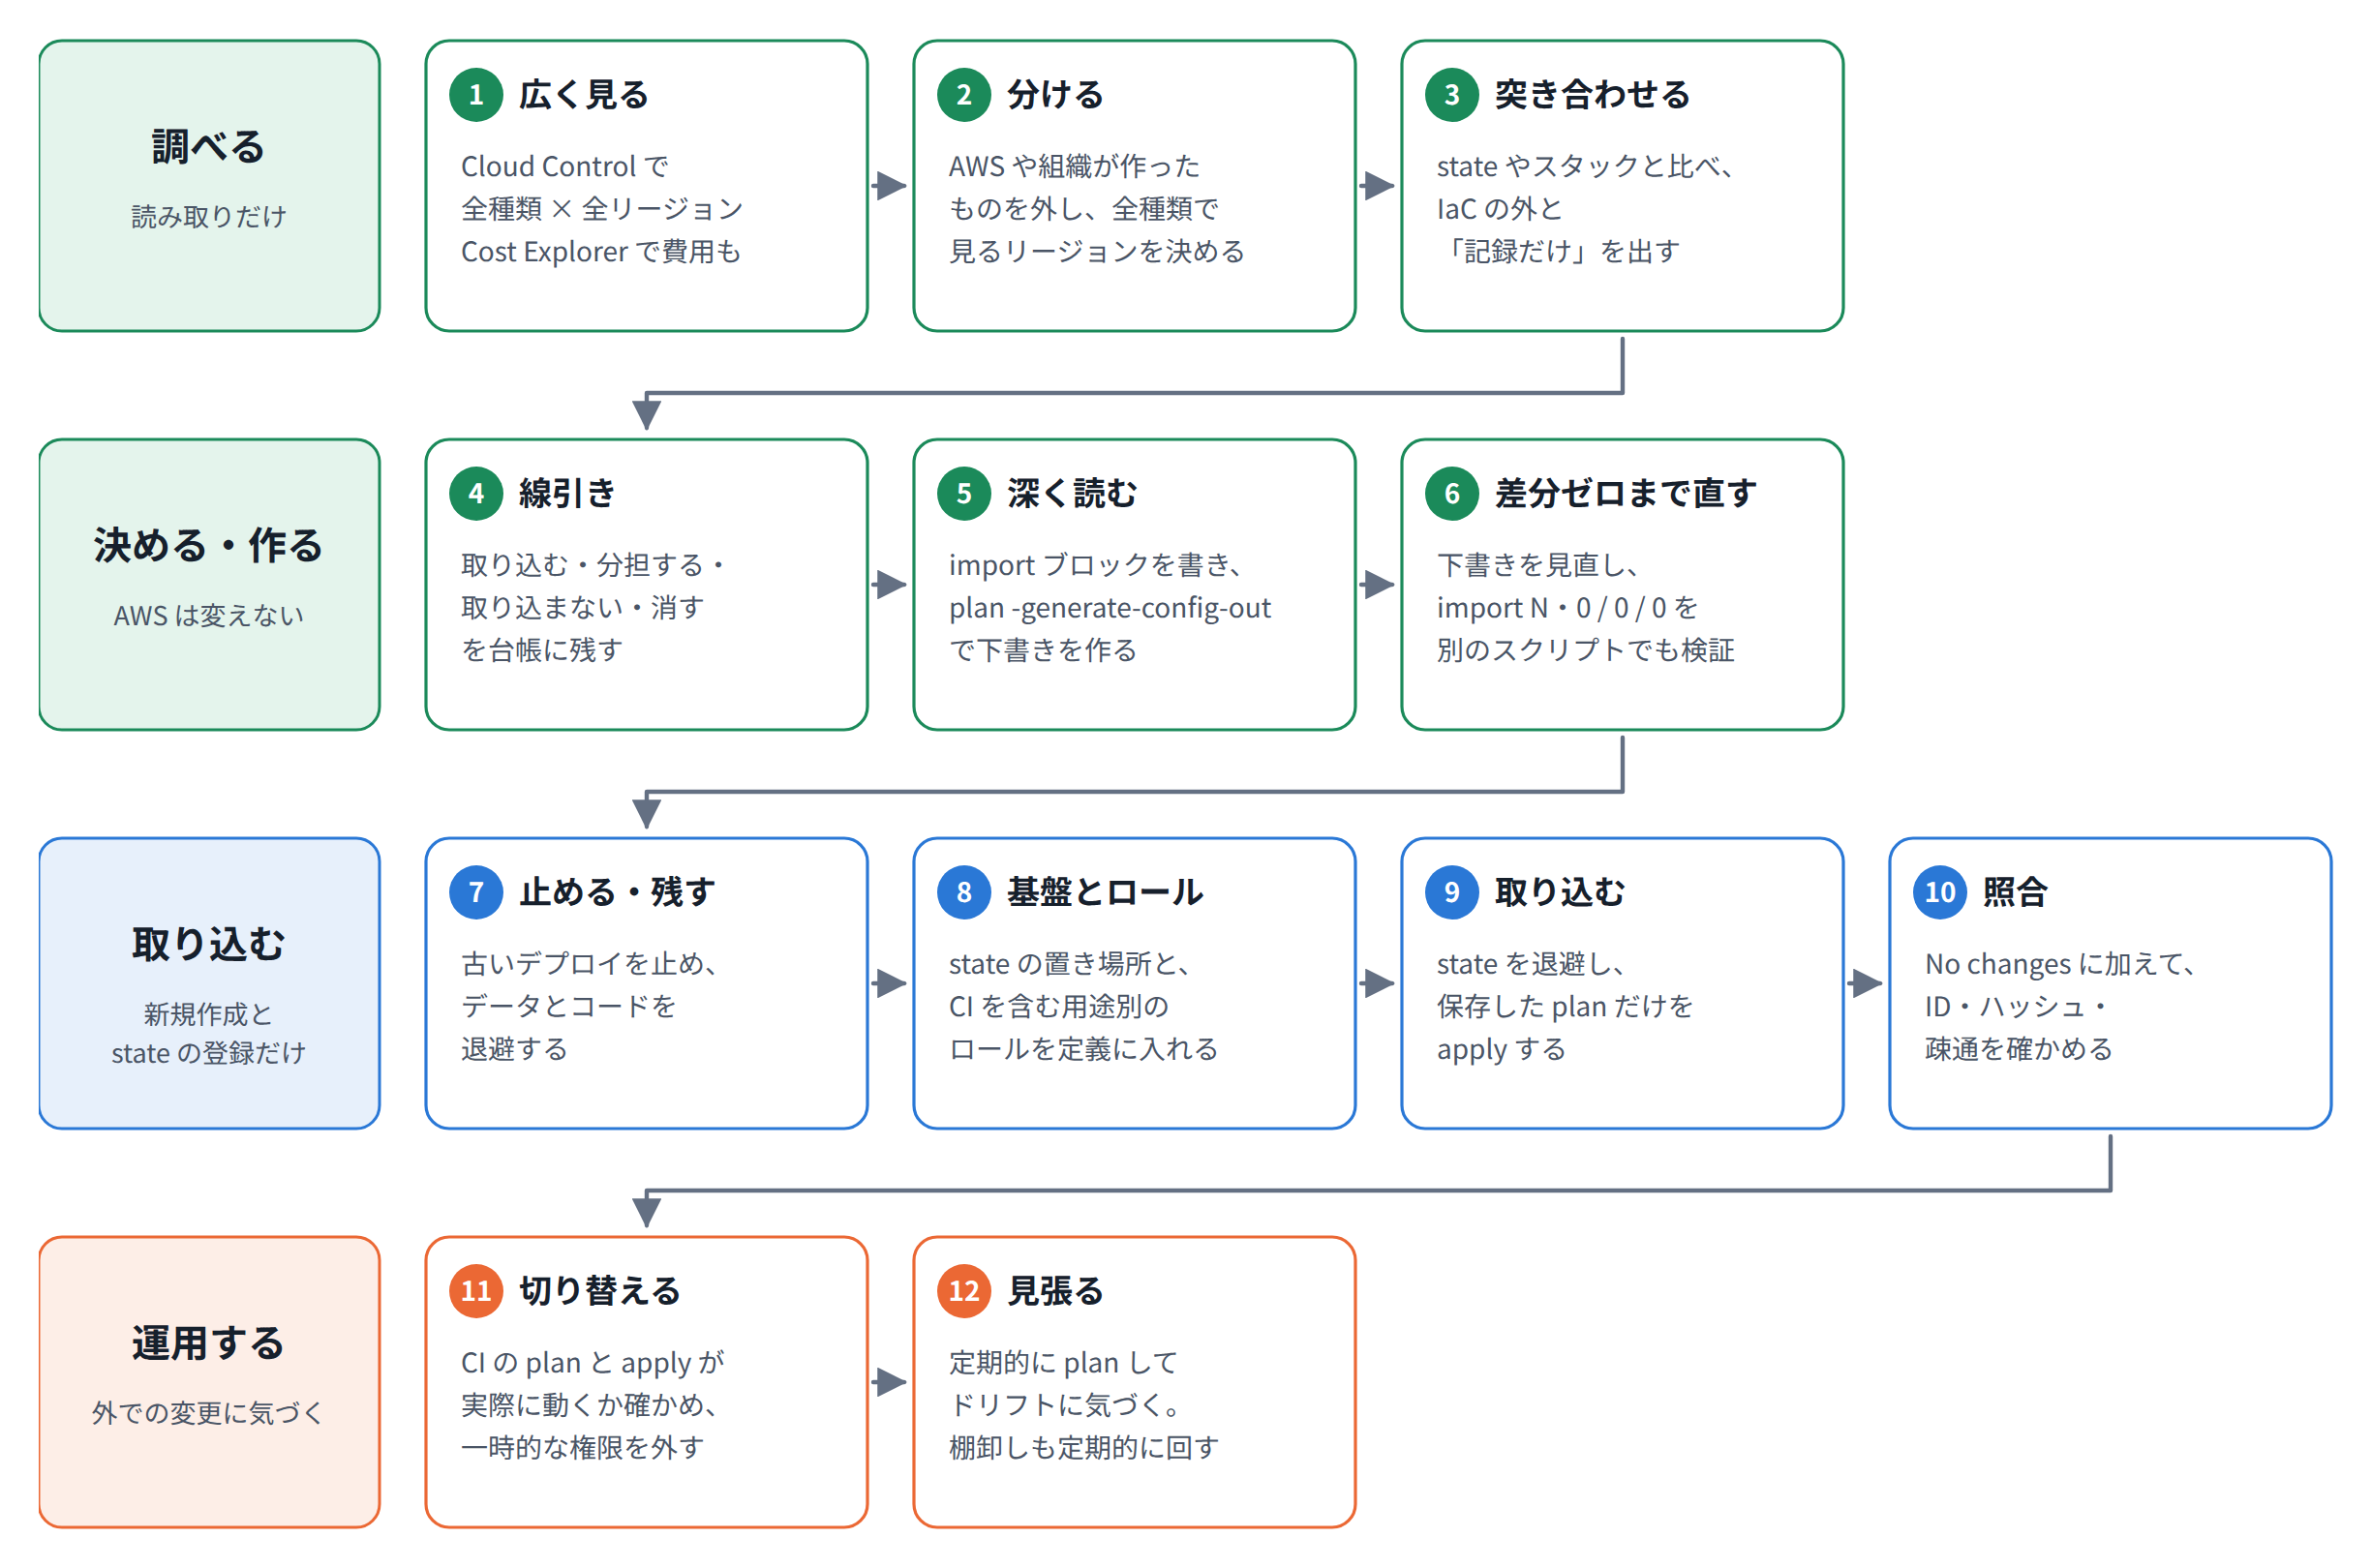
12 の手順を、AWS への影響ごとに 4 つの段に分けています。調べる(1〜3)は読み取りだけで、決める・作る(4〜6)も AWS は変えません。取り込む(7〜10)で AWS に起きるのは、新規作成と state への登録だけです。運用する(11〜12)では、CI が実際に動くかを確かめ、定期的な plan と棚卸しで、外での変更に気づけるようにします。
import ブロックで取り込み、plan が import だけになるまで apply せず、取り込んだあとはドリフトを見張る、という骨組みは、HashiCorp の 取り込みのガイド と同じです。この記事は、そこに棚卸し、権限、apply の守りを足しています。
ここからは、ここまでの話を、ほかの環境でも使えるように段階ごとの確認項目にしたものです。
棚卸し
- 実物と定義を突き合わせたか。管理元はいくつあるか(手作業で作ったものも含む)
- 「定義にあって実物にないもの」と「実物にあって定義にないもの」を分けたか
- タグに頼らない一覧(Cloud Control API など)で、有効な全リージョンを見たか
- 取り込む種類は、設定の中身まで読んだか(サービスの API か、import ブロックと plan で)
- 調べていない範囲(一覧にできなかった種類など)を書いたか
- リージョン別の費用(使用量)に、説明のつかないものがないか
- AWS が用意したもの、デフォルト VPC、組織の基盤を、自分のものと分けたか
- 調査の生データに秘密が混ざっていないか。Git に入れていないか
線引き
- ほかと共有の基盤など、自分たちだけのものではないものを外したか
- アプリが実行中に書き換える属性はどれか。
ignore_changesは属性 1 つに絞ったか - provider が対応していないものを、どう守るか決めたか
- 用途がわからないものを「消さない・取り込まない」で残す判断をしたか
- 使われていないように見える資格情報(古い IAM ユーザーやキー)を、調べる前に消していないか
- コードや Secret の値など、Terraform に持たせないものを決めたか
- 判断と理由を、台帳に残したか
定義と plan
- 定義を実物に合わせたか(定義に合わせて実物を変えていないか)
- import の一覧と plan を、別のスクリプトで突き合わせたか(過不足、no-op 以外、削除)
- plan の差分を、provider の既定値や空のブロックによるものと、実物の変更とに分けたか
- 調査が不完全なまま plan を作っていないか
- 取り込みのあいだ、provider の
default_tagsを外したか - 自動生成は初回だけにしたか
- 自動で作った定義の下書き(
-generate-config-outなど)を、そのまま使っていないか。不正な値、既定のままでよい属性、作るときだけの設定を見直したか
取り込む前
- 古いデプロイの仕組みを止めたか。新しい仕組みも、終わるまで動かないようにしたか
- データとコードのバックアップを取り、ハッシュで確かめたか
- 段階ごとの戻し方を書いたか。state を手で編集しない、と決めたか
state
- アカウント(環境)ごとに分けたか。基盤とアプリで分けたか
- バージョニング、暗号化、ロック、公開ブロックを設定したか
- 生の plan と state を、CI の artifacts などに置いていないか
権限
- 管理者権限を使う操作を、最小限(ロールを作るだけ、など)に絞ったか
- 渡された認証情報が、本当に読み取り専用か確かめたか
- AWS 管理のポリシー(ViewOnlyAccess、ReadOnlyAccess)で足りるか、広すぎないかを確かめたか
- 調査ロールで、アプリのデータを読めないようにしたか
- plan、apply、アプリの配布、Secret の更新で、ロールを分けたか
PassRoleの渡し先を絞り、boundary を外せないようにしたか- 例外に、条件と撤去の手順があるか
- 実際に動かして、足りない権限を確かめたか
apply
- どのブランチから、どう起動したときだけ apply できるか
- apply するのは、レビューした plan と同じものか(ハッシュ、コミット、期限)
- 削除と置換を、既定で拒否しているか
確認の自動化
- 確認を手作業ではなく、スクリプトにしたか。結果をファイルに残しているか
- 手順書に書いた仕組み(CI、承認のゲート、ロール)が、実際に作られて動いているか。CI は一度でも最後まで通ったか
- アカウントの取り違えを、スクリプトと変数の validation の両方で止めているか
- state のロックと、古いバージョンからの戻し方を、実際に試したか
- 確認用のスクリプトにも、失敗するべき入力で失敗するテストがあるか
照合
- plan の No changes に加えて、実物(ID、コードのハッシュ、スキーマ、疎通)を確かめたか
- 確かめていないことを、記録に書いたか
取り込んだあと
- 定期的に plan して、Terraform の外での変更(ドリフト)に気づけるか
- 定期的に棚卸しを回して、IaC の外のものが増えていないか
- 取り込みが終わった import ブロックを、消すか、記録として残すかを決めたか
環境
- 環境の差(意図した機能の差)と、drift(定義と実物のずれ)を分けて考えたか
- 環境の差を、名前、機能、設定値に分けて表したか
- 本番にない機能を、本番で作らない仕組みになっているか
- アドレスの移動を
movedで残したか。移したあとも、plan で設定の差がないことを確かめたか
運用の分担
- インフラ、アプリのコード、Secret の値を、別の経路と別の権限で更新するか
- アプリの配布が、Terraform の出力をどこから読むか決めたか
検査
- ソースと plan のどちらで、マージを止めるか
- 除外に理由があるか。「既存だから」だけで除外していないか
- 指摘を直すことで壊れるもの(匿名で配っている公開物など)はないか
AI に任せるとき
- AI エージェントを、管理者から落とした限定ロールで動かしているか
- 許可の範囲(ブランチ、マージ、apply、本番)を言葉で書いたか
- main へのマージや本番の apply の前に、人の確認を挟んでいるか(ブランチの保護、権限)
- 完了の報告を、「何が終わって、何が残っているか」で確かめたか
- まだ終わっていないことと、確かめていないことを、記録に書かせたか
おわりに
本番の取り込みのあと、次のことを終えました。
- 元の IaC ツールからの切り離し。物理リソースはそのままで、208 件の ID、Lambda、DynamoDB、公開 URL を確かめ直した
- 一時的なロールと権限を撤去した
- main への統合
- 本番の配布を有効にし(
deployment_ready = true)、7 つのサービスを本番に配布できることを確かめた
切り離しのあと、plan に 1 件だけ差分が出ました。EventBridge のルールの説明文(日本語)が、AWS 側で文字化けして見えていたものです。今回の作業が原因ではないことを確かめ、別の課題に切り出しました。「差分 0」が崩れたときは、まず原因が今回の作業かどうかを切り分けています。
取り込みは、AWS の実物をほとんど変えない作業です。そのぶん、権限、止める順番、確かめることを先に決めておけば、本番でも「変更 0」で終えられました。